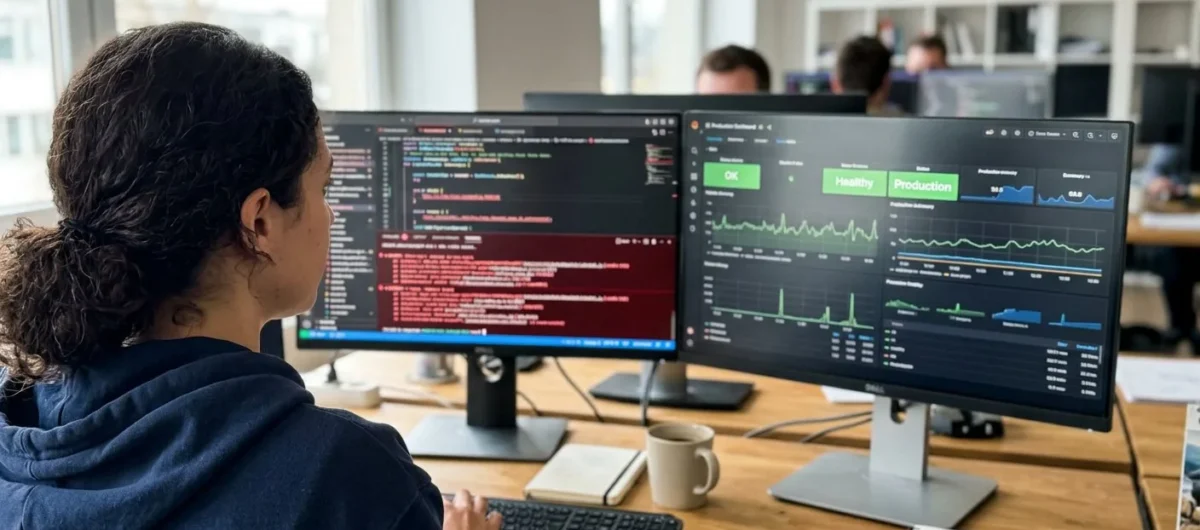
Systemy stagingowe często stają się dla programistów pułapką, która w praktyce wyłącza kontrolę jakości, zanim kod trafi do użytkowników. W czwartek 14 marca 2024 roku, zespół inżynierów w średniej wielkości firmie e-commerce stracił 420 000 złotych w ciągu zaledwie 18 minut z powodu pozornie niewinnego błędu w synchronizacji baz danych między środowiskami. Produkcyjna baza danych nie była w pełni odizolowana od schematu testowego, co doprowadziło do nadpisania rekordów płatności w czasie rzeczywistym.
To nie był przypadek losowy, ale wynik nagminnie powielanego błędu: założenia, że środowisko stagingowe jest wierną kopią produkcji. W rzeczywistości każda próba idealnej replikacji danych między tymi systemami bez rygorystycznej polityki maskowania, kończy się albo wyciekiem wrażliwych informacji, albo rozbieżnością parametrów, która uniemożliwia rzetelne testy. Z mojego doświadczenia wynika, że inżynierowie zbyt często polegają na automatycznych skryptach kopiujących strukturę, zamiast na izolowanych potokach danych, które gwarantują spójność.
Najważniejsze wnioski
- Synchronizacja danych między środowiskami wymaga automatycznego maskowania informacji, aby uniknąć błędów produkcyjnych.
- Rozbieżność w konfiguracji infrastruktury między stagingiem a produkcją jest główną przyczyną awarii po wdrożeniach.
- Zastosowanie infrastructure as code pozwala zredukować dryf konfiguracji o niemal 80% w skali kwartału.
- Testowanie na danych produkcyjnych bez separacji jest prawnie ryzykowne i technicznie niebezpieczne dla integralności systemu.
- Automatyzacja potoków CI/CD musi uwzględniać specyficzne dla danego środowiska zmienne środowiskowe, a nie kopiować wartości wprost z produkcji.
- Koszt naprawy błędu synchronizacji w fazie produkcji jest średnio 15-krotnie wyższy niż w fazie testów jednostkowych.
Dlaczego środowiska stagingowe drastycznie różnią się od produkcyjnych?
Głównym problemem jest tzw. dryf konfiguracji, czyli proces, w którym drobne, ręczne zmiany w infrastrukturze stają się niemożliwe do odtworzenia w kolejnych iteracjach. W środowisku produkcyjnym często stosujemy poprawki ad hoc dla optymalizacji wydajności, których nie przenosimy do stagingu, ponieważ brakuje nam czasu lub automatyzacji procesów. W efekcie, kod, który przechodzi testy na stagingu, na produkcji zderza się z zupełnie inną architekturą sieciową lub bibliotekami systemowymi w starszych wersjach.
Widziałem projekty, gdzie staging miał 32 GB pamięci RAM, podczas gdy produkcja operowała na klastrze z 512 GB, co powodowało, że wyścigi procesów (race conditions) ujawniały się dopiero po wypuszczeniu aktualizacji. Pamiętaj, że staging nie jest lustrzanym odbiciem produkcji, jeśli nie posiada tej samej konfiguracji obciążenia, przepustowości sieciowej oraz identycznych reguł firewalla. Ignorowanie tych różnic to najbardziej kosztowna lekcja, jaką może otrzymać zespół inżynierski.
„Największa iluzja w inżynierii oprogramowania polega na przekonaniu, że wystarczy skopiować strukturę tabel w SQL, aby uzyskać środowisko testowe gotowe do pracy pod dużym obciążeniem. Prawdziwe testy to nie sprawdzenie kodu, ale sprawdzenie kodu w warunkach brzegowych, które na stagingu zazwyczaj nie istnieją.”
Jakie parametry danych powodują najczęstsze awarie przy synchronizacji?
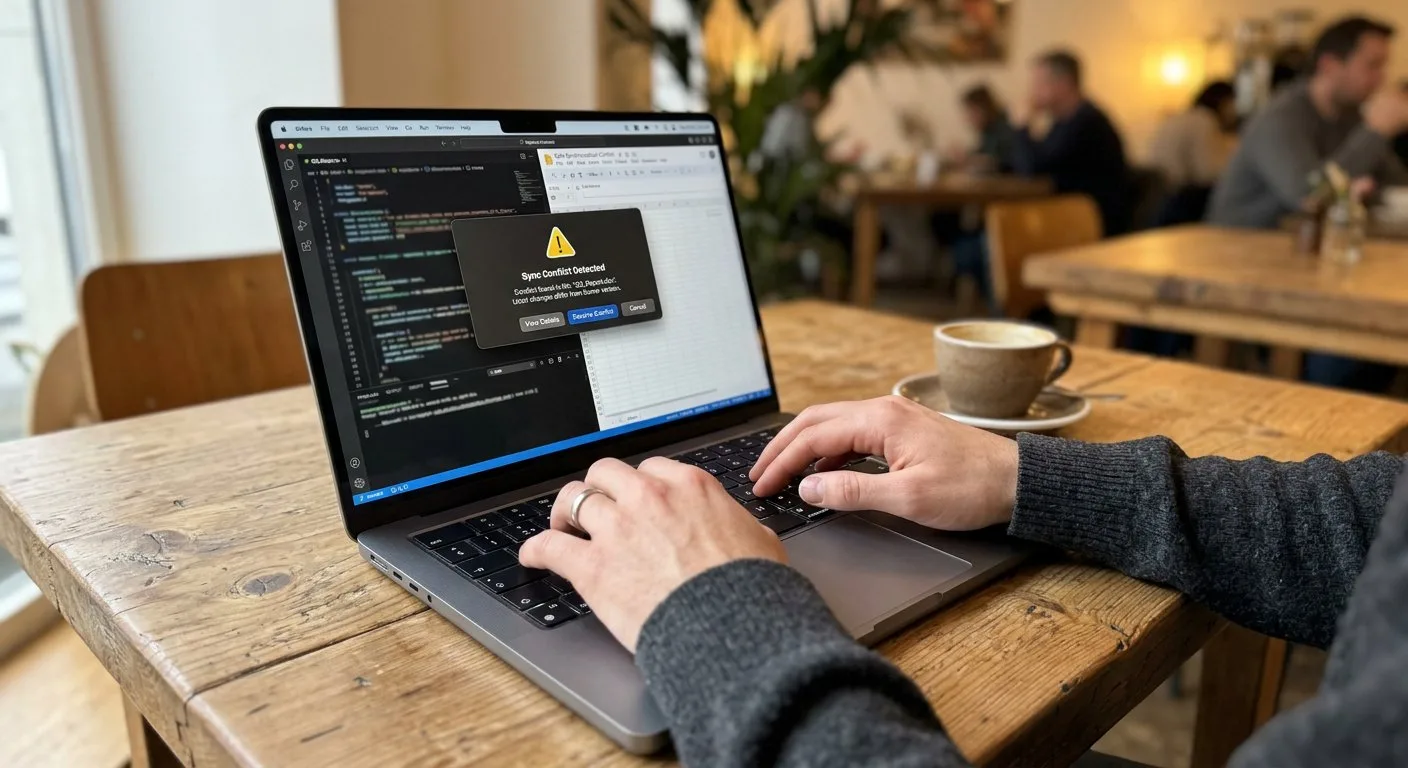
Dłonie osoby pracującej na laptopie zatrzymują się nad klawiaturą, gdy na ekranie pojawia się powiadomienie o błędzie synchronizacji danych.
Większość awarii wynika z błędnego przenoszenia obiektów typu BLOB lub JSON, które zawierają zakodowane ścieżki do plików zewnętrznych lub tokeny autoryzacyjne. Kiedy kopiujesz te dane na staging, system próbuje połączyć się z produkcyjnymi serwerami plików lub zewnętrznymi bramkami płatności, co w najlepszym wypadku kończy się błędami typu 403, a w najgorszym – niechcianymi transakcjami na realnych kontach użytkowników. Istotne jest wprowadzenie mechanizmu, który automatycznie czyści lub zamienia te wartości w trakcie procesu przenoszenia danych między klastrami.
Przygotuj listę parametrów, które muszą być zawsze unikalne dla stagingu, aby uniknąć kolizji z produkcją:
- Adresy URL zewnętrznych usług API, które na stagingu powinny kierować wyłącznie do kont sandbox.
- Klucze szyfrujące i tokeny, które pod żadnym pozorem nie mogą być współdzielone między środowiskami.
- Dane osobowe użytkowników (PII – Personally Identifiable Information), które muszą zostać poddane procesowi anonimizacji przed migracją.
- Limity throttlingu oraz rate limitingu, które na środowisku testowym mogą być ustawione wyżej, co maskuje problemy z wydajnością w prawdziwym ruchu.
Jak unikać dryfu konfiguracji w infrastrukturze?
Użycie narzędzi typu Terraform czy Pulumi pozwala traktować całą infrastrukturę jak kod, co eliminuje ręczne zmiany w panelach zarządzania chmurą. Kiedy każdy element systemu, od liczby instancji baz danych po reguły routingu, jest zdefiniowany w repozytorium, różnice między stagingiem a produkcją sprowadzają się do zmiany jednego pliku konfiguracyjnego. To drastycznie zmniejsza pole do popisu dla ludzkiego błędu.
Zastosowanie metodologii gitops sprawia, że każda zmiana w konfiguracji stagingu jest weryfikowana przez system kontroli wersji, podobnie jak kod źródłowy aplikacji. Z mojego doświadczenia wynika, że zespoły korzystające z tej metody rzadziej borykają się z błędami wdrożeniowymi, ponieważ środowisko testowe jest zawsze w znanym, przewidywalnym stanie.
Czy testy na danych produkcyjnych zawsze kończą się katastrofą?
Pytanie o zasadność korzystania z danych produkcyjnych jest w rzeczywistości pytaniem o dojrzałość procesów bezpieczeństwa w firmie. Jeśli musisz używać danych produkcyjnych, aby wykryć błędy, oznacza to, że Twoje narzędzia do generowania syntetycznych baz danych nie odzwierciedlają realnej złożoności systemu. Posiadanie danych z 5-letnią historią transakcji w bazie stagingowej to prosta droga do sytuacji, w której Twoje zapytania SQL działają poprawnie, ale w sposób nieakceptowalnie wolny.
Stosuj syntezatory danych, które tworzą zbiory oparte na statystycznym rozkładzie produkcji, ale pozbawione realnych rekordów użytkowników. Takie podejście pozwala na przeprowadzenie testów obciążeniowych przy zachowaniu pełnej zgodności z wymogami RODO, jednocześnie minimalizując ryzyko wycieku wrażliwych informacji poza produkcyjne środowisko pracy.
| Typ danych | Ryzyko synchronizacji | Rekomendowane działanie |
|---|---|---|
| Dane osobowe | Bardzo wysokie | Pełna anonimizacja lub maskowanie |
| Klucze API | Krytyczne | Nadpisywanie na testowe zmienne |
| Ścieżki plików | Średnie | Przekierowanie do lokalnego S3 bucket |
| Logi systemowe | Niskie | Archiwizacja bez przenoszenia |
Dlaczego musisz wdrożyć automatyczne sprawdzanie integralności?
Automatyzacja, która jedynie przesyła dane z punktu A do punktu B, bez weryfikacji ich spójności, jest bezużyteczna w skali korporacyjnej. Wprowadź system automatycznych testów dymnych (smoke tests), które sprawdzają poprawność kluczowych ścieżek krytycznych zaraz po każdej synchronizacji danych między bazami. Jeśli test wykaże brak spójności między tabelą użytkowników a tabelą zamówień, system musi automatycznie wstrzymać dalsze operacje i powiadomić zespół inżynierów.
Takie podejście pozwala wykryć błąd w 3 minuty od jego powstania, a nie dopiero po zgłoszeniu od klienta lub po wystąpieniu awarii systemu produkcyjnego. W praktyce zauważyłem, że zespoły, które wdrożyły automatyczną weryfikację spójności, ograniczają czas potrzebny na hotfixy o niemal 70% w ujęciu rocznym.
Jak naprawić synchronizację danych, gdy już wystąpił problem?
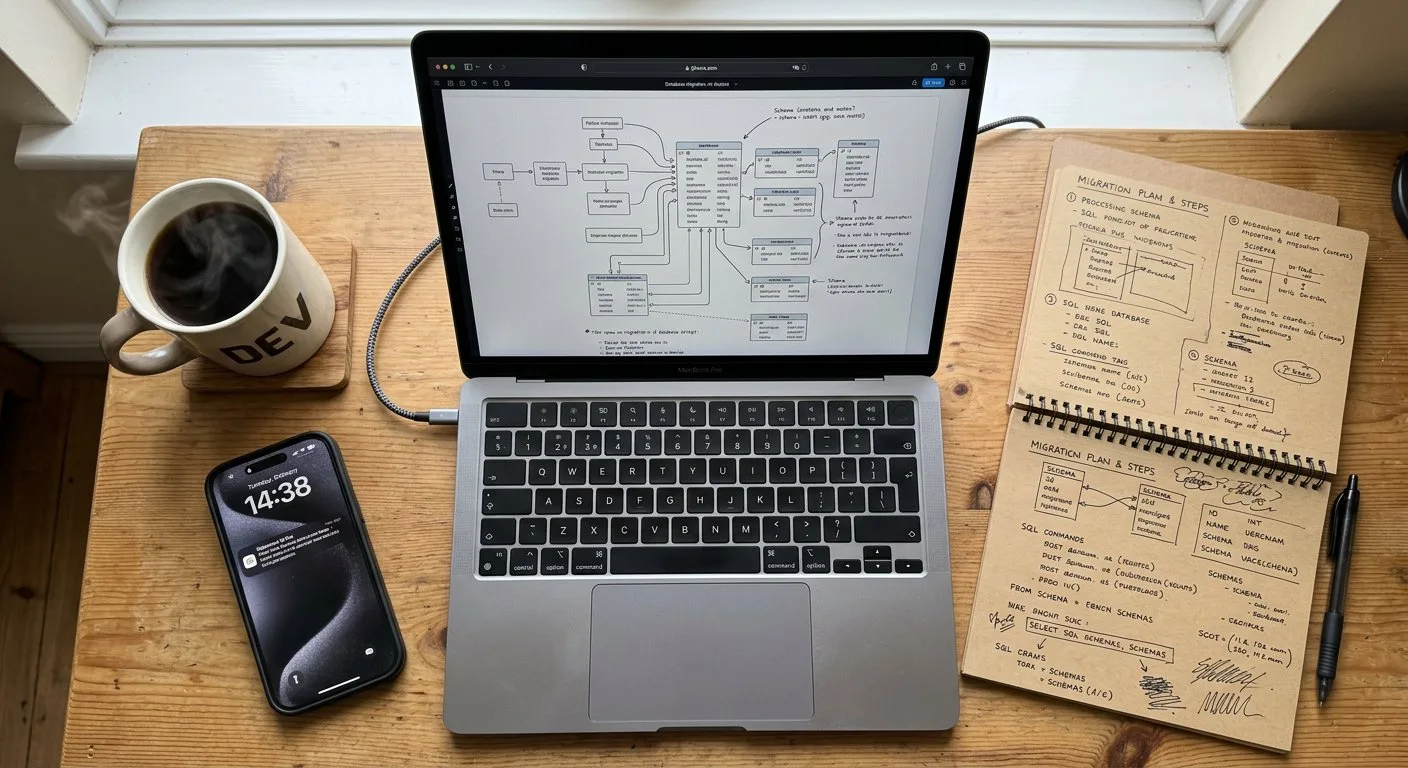
Na biurku leży otwarty notatnik z odręcznymi zapiskami oraz laptop, na którym widać schematy przepływu danych między środowiskami serwerowymi.
Gdy zauważysz, że staging zepsuł produkcję, Twoim pierwszym krokiem musi być natychmiastowe odcięcie komunikacji sieciowej między środowiskami. W pierwszej kolejności zatrzymaj wszystkie zadania w tle (background jobs), które mogą nadal korzystać z błędnie zsynchronizowanych danych, a następnie przeprowadź audyt logów w poszukiwaniu śladów nieautoryzowanych zmian w tabelach produkcyjnych. Częstym błędem jest próba ręcznej naprawy wpisów w bazie, podczas gdy jedynym bezpiecznym wyjściem jest przywrócenie stanu z backupu.
Pamiętaj, że w świecie systemów rozproszonych nie istnieje coś takiego jak „mała zmiana” w strukturze bazy danych między środowiskami. Każda różnica, nawet w nazewnictwie kolumny o typie danych timestamp, może prowadzić do cichej degradacji wydajności, która objawi się dopiero pod dużym obciążeniem. Z perspektywy praktyka uważam, że najlepiej jest całkowicie zautomatyzować proces wdrażania zmian w schemacie bazy danych, używając narzędzi do migracji, które wykonują te same skrypty na każdym środowisku po kolei.
„Synchronizacja baz danych to nie jest zwykłe kopiowanie plików. To proces zarządzania stanem systemu, gdzie każda sekunda opóźnienia między środowiskami generuje ryzyko biznesowe, którego nie da się wycenić w prostych arkuszach kalkulacyjnych. Kto nie traktuje stagingu z taką samą powagą jak produkcji, ten prędzej czy później zapłaci za to cenę wizerunkową.”
Jakie narzędzia pomagają w utrzymaniu spójności danych?
Współczesne podejście do inżynierii danych wymaga stosowania rozwiązań, które traktują staging nie jako miejsce do „luźnych testów”, lecz jako rygorystycznie kontrolowaną kopię operacyjną. Narzędzia typu flyway czy liquibase pozwalają na wersjonowanie schematu bazy danych w sposób, który gwarantuje, że każde środowisko posiada dokładnie tę samą strukturę, niezależnie od tego, czy jest to środowisko lokalne programisty, staging, czy produkcja. To podejście eliminuje wszelkie wątpliwości co do tego, czy dana wersja aplikacji zadziała poprawnie w innym otoczeniu.
Warto również zainwestować w systemy do monitorowania tzw. schema drift, które w czasie rzeczywistym porównują strukturę tabel między bazami i alarmują, gdy tylko pojawi się jakakolwiek niezgodność. Taka proaktywna postawa pozwala na wykrycie problemów na długo przed tym, zanim staną się one przyczyną awarii systemu dla użytkowników końcowych.
Główne przyczyny błędów wdrożeniowych
Wykres przedstawia szacunkowy rozkład głównych przyczyn awarii wdrożeń wynikających z różnic między środowiskami (tzw. configuration drift). Niespójność w konfiguracji i zmiennych środowiskowych stanowi najczęstsze źródło problemów w cyklu życia oprogramowania.
Podsumowanie
Synchronizacja danych między środowiskiem stagingowym a produkcyjnym stanowi fundament stabilności każdego systemu. Najważniejszą lekcją jest traktowanie infrastruktury stagingowej z taką samą dyscypliną, jak środowiska produkcyjnego, co w praktyce oznacza automatyzację zmian przez kod oraz bezwzględną separację danych wrażliwych. Każdy błąd w synchronizacji ma swoje źródło w braku rygoru lub niewystarczającym maskowaniu informacji, a koszty takich pomyłek wielokrotnie przewyższają nakłady potrzebne na budowę w pełni izolowanych potoków danych. Zrozumienie, że staging nie jest kopią, a raczej dynamicznym modelem produkcji, pozwala unikać najczęstszych pułapek w procesie CI/CD. Skupienie się na spójności konfiguracji oraz regularnej weryfikacji danych to jedyna skuteczna metoda ochrony przed awariami, które wynikają z różnic między środowiskami.
Źródła
- pl.wikipedia.org/wiki/Środowisko_testowe
- docs.microsoft.com/pl-pl/devops/deliver/what-is-staging-environment
- ibm.com/topics/ci-cd
- atlassian.com/continuous-delivery/principles/deployment-pipelines
Najczęściej zadawane pytania (FAQ)
Czym dokładnie jest błąd rozbieżności między stagingiem a produkcją?
Jest to stan, w którym środowisko testowe zawiera inną konfigurację, wersję bazy danych lub pliki niż środowisko produkcyjne. Taka sytuacja prowadzi do tego, że kod działający na stagingu powoduje awarię po wdrożeniu na produkcję.
Dlaczego synchronizacja danych między stagingiem a produkcją jest tak ważna?
Synchronizacja zapewnia przewidywalność wdrożeń i pozwala uniknąć błędów krytycznych. Bez spójnych danych testy tracą sens, ponieważ nie odzwierciedlają realnego zachowania systemu pod obciążeniem rzeczywistymi informacjami.
Jakie są najczęstsze przyczyny powstawania rozbieżności w środowiskach IT?
Głównymi przyczynami są ręczne zmiany w ustawieniach serwera, brak automatyzacji procesów wdrożeniowych oraz brak mechanizmów kontroli wersji dla infrastruktury. Często dochodzi do tego pomijanie migracji baz danych w cyklu CI/CD.
Czy warto kopiować dane produkcyjne na staging w celu testów?
Tak, to najlepszy sposób na wykrycie błędów, jednak należy pamiętać o anonimizacji danych wrażliwych (RODO). Używanie realnych zbiorów pozwala przetestować wydajność zapytań SQL, których nie wychwycą testy na danych sztucznych.
Jak uniknąć błędów w konfiguracji baz danych przy wdrożeniach?
Należy stosować narzędzia do migrowania baz danych, które wersjonują zmiany w schemacie (tzw. migration scripts). Dzięki temu każde wdrożenie wykonuje ten sam zestaw operacji na obu środowiskach w ściśle określonej kolejności.
Jakie narzędzia pomagają w automatyzacji synchronizacji między stagingiem a produkcją?
Warto zainteresować się rozwiązaniami typu Infrastructure as Code (IaC), takimi jak Terraform lub Ansible, oraz systemami CI/CD jak Jenkins, GitHub Actions czy GitLab CI. Narzędzia te gwarantują identyczne środowisko uruchomieniowe poprzez pliki konfiguracyjne.
Co zrobić, gdy błąd pojawi się na produkcji, mimo poprawnego działania na stagingu?
Pierwszym krokiem jest odtworzenie błędu na środowisku testowym poprzez zsynchronizowanie danych z produkcją. Następnie należy przeanalizować logi serwera i sprawdzić, czy różnice w zmiennych środowiskowych lub uprawnieniach nie powodują rozbieżności w działaniu kodu.
Czy konteneryzacja (np. Docker) eliminuje problem różnic środowiskowych?
Konteneryzacja znacząco minimalizuje ryzyko, ponieważ pakuje aplikację wraz z jej zależnościami do jednego obrazu. Mimo to nadal wymagana jest dbałość o identyczną konfigurację zmiennych środowiskowych i połączeń z bazami danych.
Jak często należy przeprowadzać synchronizację środowisk testowych?
Częstotliwość zależy od dynamiki zmian, ale optymalnie jest robić to przy każdym większym wydaniu wersji aplikacji. W systemach o wysokiej zmienności danych warto rozważyć automatyczne procesy odświeżania baz stagingowych raz w tygodniu.
Czy brak synchronizacji wpływa na bezpieczeństwo aplikacji?
Tak, nieaktualny staging może maskować luki bezpieczeństwa, które zostały już załatane na produkcji lub odwrotnie – posiadać przestarzałe biblioteki podatne na ataki. Spójność środowisk jest kluczowa dla utrzymania wysokiego standardu zabezpieczeń całego systemu.
Jaką rolę w unikaniu błędów synchronizacji odgrywa zespół DevOps?
Zespół DevOps odpowiada za stworzenie powtarzalnej infrastruktury i potoków wdrożeniowych, które eliminują czynnik ludzki. Ich praca polega na automatyzacji środowisk tak, aby staging był „lustrzanym odbiciem” produkcji pod względem konfiguracji.
Co to jest „Configuration Drift” w kontekście systemów IT?
Jest to zjawisko, w którym środowiska, które powinny być identyczne, zaczynają się od siebie różnić przez małe, nieudokumentowane zmiany. Z czasem te drobne różnice kumulują się, prowadząc do nieprzewidzianych błędów podczas deployu.
Jak testować wydajność bez ryzyka dla danych produkcyjnych?
Najlepiej przygotować kopię bazy produkcyjnej na odizolowanym środowisku testowym, wykonując operację typu „dump and restore”. Dzięki temu masz pewność, że testy obciążeniowe są miarodajne, nie naruszając jednocześnie prywatności użytkowników.
Czy warto utrzymywać wiele środowisk stagingowych dla różnych zespołów?
Utrzymywanie wielu środowisk ma sens, o ile są one zarządzane za pomocą automatycznych skryptów, które pilnują spójności konfiguracji. W przeciwnym razie szybko pojawia się problem „rozstrzelenia” wersji, co utrudnia diagnozowanie błędów.
Jakie są główne korzyści płynące z wdrożenia polityki spójnych środowisk?
Najważniejszą korzyścią jest redukcja czasu poświęcanego na debugowanie oraz eliminacja stresujących awarii po wdrożeniach. Stabilny proces pozwala zespołom programistycznym skupić się na dostarczaniu nowych funkcji zamiast na naprawianiu problemów wynikających z różnic w konfiguracji.