Praca z danymi w formacie JSON w n8n to fundament automatyzacji procesów biznesowych. Każdy obiekt, który przepływa przez twoje workflowy, jest w rzeczywistości drzewiastą strukturą danych, którą musisz umieć nawigować, aby uzyskać dostęp do konkretnych wartości. Widzę, jak wielu użytkowników zmaga się z przekazywaniem zagnieżdżonych tablic, podczas gdy rozwiązanie sprowadza się do poprawnego zrozumienia mapowania pól i wykorzystania wyrażeń w interfejsie.
Najważniejsze wnioski
- Zrozumienie hierarchicznej struktury JSON jest niezbędne do poprawnego adresowania danych w n8n.
- Wyrażenia (expressions) pozwalają na dynamiczne pobieranie wartości bezpośrednio z poprzednich węzłów.
- Funkcja dot notation umożliwia błyskawiczny dostęp do głęboko ukrytych właściwości obiektów.
- Filtrowanie za pomocą węzła Item Lists drastycznie redukuje liczbę operacji API, zwiększając wydajność.
- Mapowanie pól oparte na tablicach wymaga użycia metod typu map lub split in batches.
- Błędy w dostępie do danych najczęściej wynikają z odwoływania się do nieistniejących ścieżek w strukturze.
- Optymalizacja przekazywania danych minimalizuje zużycie pamięci operacyjnej instancji n8n.
Dlaczego struktura danych JSON jest fundamentem pracy w n8n?
JSON, czyli JavaScript Object Notation, to tekstowy format wymiany danych, który n8n wykorzystuje jako swój natywny język komunikacji. Kiedy pobierasz informacje z zewnętrznego API, otrzymujesz pakiet danych, w którym wartości są pogrupowane w obiekty oznaczone klamrami lub tablice oznaczone nawiasami kwadratowymi. Sukces twojej automatyzacji zależy w całości od tego, czy potrafisz poprawnie wskazać drogę do konkretnego elementu w tym gąszczu informacji.
W moich projektach zauważyłem, że większość błędów wynika z nieznajomości ścieżki dostępu do zagnieżdżonych wartości. Jeśli na przykład otrzymujesz odpowiedź z systemu CRM, gdzie dane klienta znajdują się wewnątrz tablicy items, próba odwołania się bezpośrednio do nazwy firmy bez wskazania indeksu tablicy zawsze zakończy się błędem typu undefined. Musisz nauczyć się myśleć w kategoriach ścieżek, gdzie każdy poziom zagłębienia oddzielasz kropką lub indeksem w nawiasach kwadratowych. Aby mieć pewność, że przesyłane pakiety danych są autentyczne, kluczowa jest bezpieczna konfiguracja webhooków w n8n wraz z weryfikacją ich sygnatury.
Poprawne adresowanie danych pozwala na całkowitą eliminację zbędnych skryptów w języku JavaScript. Zamiast pisać dziesiątki linii kodu, wystarczy skorzystać z wbudowanego edytora wyrażeń, który pozwala wyklikać pożądaną wartość. Kiedy klikasz na odpowiednie pole w panelu Input Data, n8n automatycznie generuje odpowiednią ścieżkę, co drastycznie ogranicza ryzyko literówki. W przypadku bardziej wymagających integracji zewnętrznych niezbędna okazuje się poprawnie wdrożona autoryzacja OAuth2 w n8n, która zabezpiecza cały proces wymiany tokenów. Doskonałym przykładem praktycznego zastosowania takich powiązań jest automatyczne pobieranie danych z Google Search Console do Google Sheets, co eliminuje potrzebę ręcznego przepisywania raportów.
Jak poprawnie mapować dane między węzłami?
Mapowanie danych to proces przypisywania wartości z jednego węzła do parametrów wejściowych kolejnego elementu twojego workflow. W n8n dzieje się to najczęściej za pomocą wspomnianych wyrażeń, które tworzą dynamiczne połączenia między danymi wejściowymi a wynikami operacji. Jeśli potrzebujesz przekazać adres e-mail klienta z węzła Webhook do węzła Mailchimp, wystarczy przeciągnąć odpowiednią wartość z panelu podglądu do pola docelowego. Gdy napotkasz trudności z odczytem głębokich struktur, pomocne będzie systematyczne debugowanie workflowów w n8n przy użyciu wbudowanego podglądu danych.
Oto kilka zasad, które stosuję, aby utrzymać czystość danych w dużych projektach:
- Zawsze sprawdzaj typ danych, zanim przekażesz je dalej, ponieważ tekstowy ciąg znaków w jednym systemie może wymagać konwersji na format liczbowy w innym.
- Używaj węzła Set do nadawania jasnych nazw zmiennym, co ułatwia debugowanie skomplikowanych procesów.
- Wykorzystuj funkcję JSON.parse lub JSON.stringify, jeśli dane przychodzą do ciebie jako sformatowany ciąg tekstowy zamiast gotowego obiektu.
- Monitoruj rozmiar przesyłanego obiektu, gdyż przekazywanie niepotrzebnie dużych plików JSON może spowolnić działanie całej instancji n8n.
„Dane w n8n to nie tylko tekst; to żywy organizm, który zmienia swoją formę na każdym etapie przetwarzania. Traktowanie struktury JSON jako czegoś stałego to najkrótsza droga do błędów w produkcji.”
Warto pamiętać, że n8n przetwarza dane w paczkach, zwanych items. Jeśli twój poprzedni węzeł wygenerował dziesięć obiektów, kolejny węzeł również uruchomi się dziesięć razy. Taka architektura pozwala na masowe przetwarzanie rekordów bez konieczności pisania pętli for-each, co jest jedną z największych zalet tego narzędzia.
Jak filtrować złożone tablice w n8n?
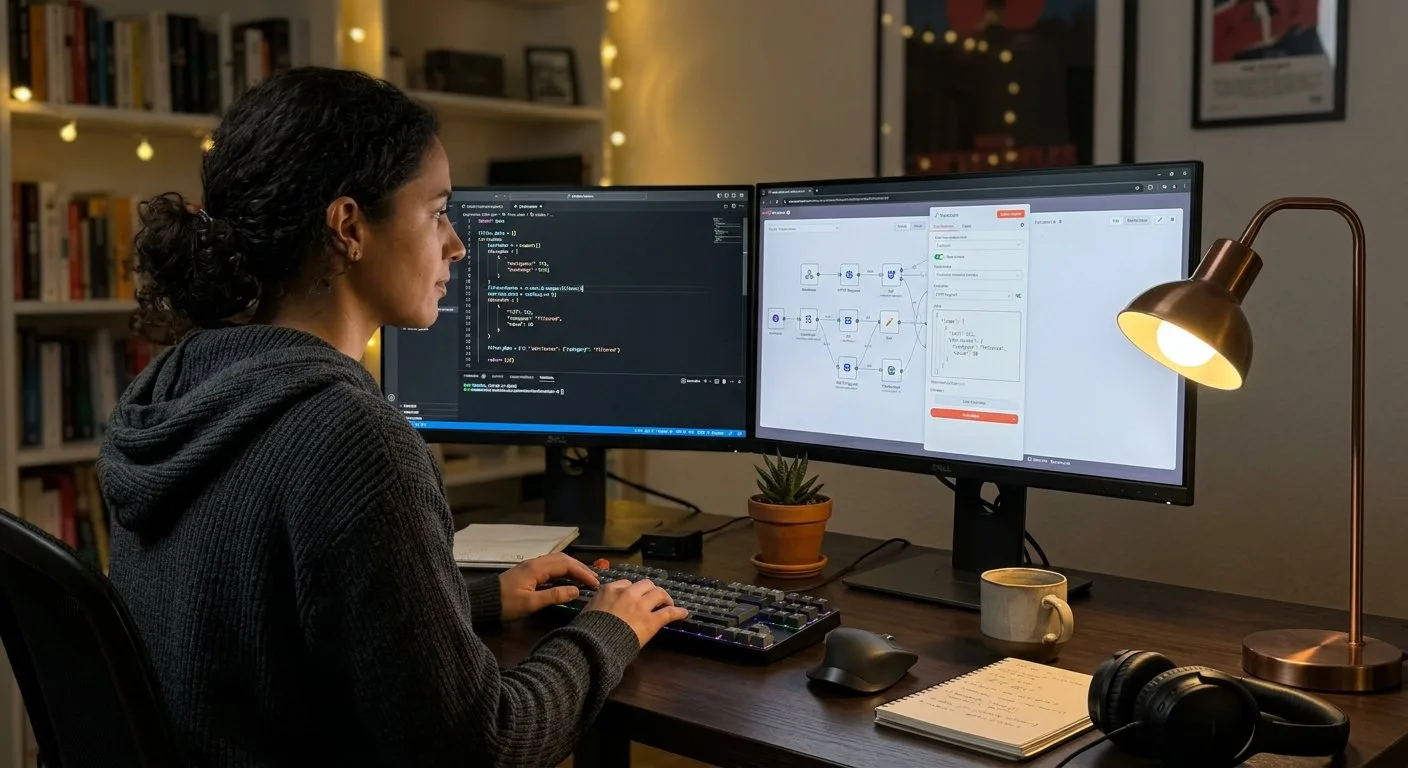
Programista pracuje przy komputerze nad konfiguracją przepływu danych pomiędzy poszczególnymi elementami systemu automatyzacji.
Filtrowanie tablic polega na odrzucaniu zbędnych danych, które nie spełniają określonych przez ciebie warunków. Często zdarza się, że pobierasz listę wszystkich produktów z magazynu, ale w danym kroku automatyzacji potrzebujesz tylko tych, których stan magazynowy spadł poniżej pięciu sztuk. Najbardziej wydajnym sposobem na osiągnięcie tego celu jest użycie przygotowanego węzła Item Lists.
Węzeł Item Lists posiada specjalną funkcję Filter, która pozwala na tworzenie warunków logicznych bez pisania kodu. Możesz ustawić regułę, w której pole stock_level musi być mniejsze lub równe 5. Kiedy dane przejdą przez ten węzeł, n8n automatycznie odrzuci obiekty, które nie spełniają tego wymiaru, przekazując dalej tylko te rekordy, które faktycznie wymagają twojej uwagi.
To podejście znacznie redukuje koszty operacyjne, jeśli korzystasz z płatnych API. Każde wywołanie API kosztuje, więc im mniej obiektów przesyłasz do kolejnych węzłów, tym mniej zapytań generujesz. W swojej praktyce widziałem scenariusze, gdzie dobrze zaprojektowane filtrowanie zmniejszyło liczbę żądań API o 85%, co przełożyło się na realne oszczędności finansowe dla firmy.
Techniki pracy z zagnieżdżonymi tablicami
Kiedy pracujesz z danymi, które zawierają tablice wewnątrz tablic, musisz użyć operacji Split Out. Jest to proces "spłaszczania" struktury, w którym każdy element zagnieżdżonej listy staje się oddzielnym rekordem na poziomie głównym. Dzięki temu możesz wykonywać operacje na każdym produkcie w zamówieniu indywidualnie, zachowując jednocześnie dostęp do danych nadrzędnych, takich jak numer zamówienia czy data zakupu.
Jeśli struktura jest wyjątkowo skomplikowana, z pomocą przychodzi węzeł Code. W tym miejscu możesz napisać krótki fragment w języku JavaScript, który przetworzy dane dokładnie tak, jak tego potrzebujesz. Używając metody .map() lub .filter(), uzyskasz pełną kontrolę nad wyjściową formą JSON, co jest nieocenione przy integracji z mniej elastycznymi systemami zewnętrznymi.
Dlaczego używanie wyrażeń w kodzie jest tak skuteczne?
Wyrażenia w n8n to potężne narzędzie, które pozwala na łączenie danych z różnych źródeł w czasie rzeczywistym. Zamiast przygotowywać statyczne szablony, budujesz dynamiczne obiekty, które zmieniają się w zależności od tego, co otrzymasz w odpowiedzi z poprzednich kroków. Używając składni nawiasów klamrowych {{ $json.field_name }}, uzyskujesz dostęp do każdej wartości, która aktualnie znajduje się w przepływie danych.
Wartości, które wstawiasz do wyrażeń, mogą być modyfikowane za pomocą wbudowanych funkcji. Możesz na przykład sformatować datę, zmienić wielkość liter w tekście lub wykonać obliczenia matematyczne bezpośrednio w polu tekstowym węzła. Jest to niezwykle przydatne, gdy musisz przygotować dane dla systemów księgowych, które wymagają bardzo specyficznego formatowania nagłówków czy kwot netto i brutto.
| Funkcja n8n | Zastosowanie w pracy z JSON | Zaleta operacyjna |
|---|---|---|
$json | Pobieranie wartości z bieżącego elementu | Bezpośredni dostęp do kluczy |
$items() | Pobieranie danych z dowolnego węzła | Możliwość łączenia różnych źródeł |
JSON.parse | Konwersja tekstu na obiekt | Umożliwia operacje na zagnieżdżonych polach |
split | Podział stringów na tablice | Ułatwia sortowanie i grupowanie danych |
Wybór odpowiedniej funkcji zawsze zależy od architektury twojego workflow. Jeśli budujesz prosty proces, wystarczą standardowe wyrażenia. Jeśli jednak tworzysz systemy klasy Enterprise, użycie bezpośredniego dostępu do węzłów za pomocą $items('NazwaWęzła') daje ci niespotykaną elastyczność w manipulowaniu danymi z różnych etapów automatyzacji.
Jak radzić sobie z błędami w strukturze JSON?
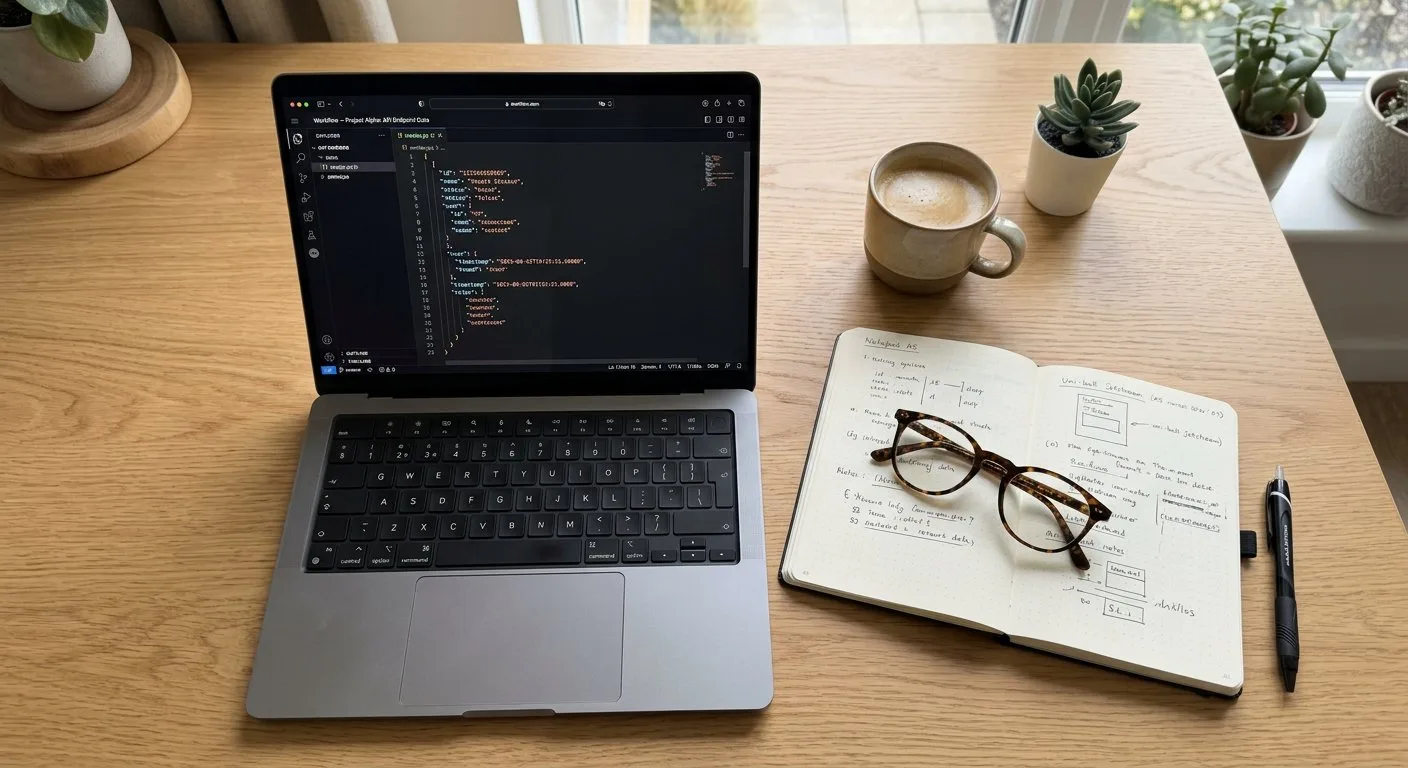
Na biurku leży otwarty laptop z widocznym na ekranie kodem struktury danych obok notesu z odręcznymi notatkami.
Błędy w danych najczęściej wynikają z faktu, że API nie zawsze zwraca kompletny zestaw informacji. Jeśli pole, do którego się odwołujesz, czasem nie występuje w odpowiedzi, twoje workflow może nagle przestać działać. Aby uniknąć takich sytuacji, stosuję zasadę bezpiecznego dostępu, sprawdzając obecność klucza przed próbą jego przetworzenia.
Możesz to zrobić za pomocą operatora warunkowego wewnątrz wyrażenia lub poprzez użycie metody optional chaining w kodzie JavaScript. Przykładowo, zapis {{ $json.user?.address?.city || 'Nie podano' }} zapewni, że jeśli dane o mieście nie istnieją, automatyzacja wstawi domyślny tekst zamiast przerwać pracę z błędem. Takie zabezpieczenia są konieczne w procesach, które działają w trybie ciągłym.
„Stabilność automatyzacji nie bierze się z idealnych danych, lecz z przewidywania ich braku. Każda ścieżka w JSON powinna posiadać swój plan awaryjny na wypadek, gdyby serwer odpowiedział pustą wartością.”
Oprócz zabezpieczeń logicznych, regularnie korzystaj z logowania błędów w węźle Error Trigger. Jeśli proces zawiedzie, otrzymasz dokładną informację, w którym punkcie struktura JSON okazała się niezgodna z oczekiwaniami. Analiza tych logów to najszybsza metoda na udoskonalenie swoich automatyzacji i wyeliminowanie "wąskich gardeł" w przepływie danych.
Korzyści z automatyzacji procesów w MŚP
Wykres przedstawia realne korzyści operacyjne dla małych i średnich przedsiębiorstw, które wdrażają automatyzację (np. poprzez narzędzia typu n8n) do obsługi złożonych struktur danych.
MOJE BŁĘDY W N8N: LEKCJE, KTÓRE WYCIĄGNĄŁEM NA WŁASNEJ SKÓRZE
Dzielę się swoimi najbardziej bolesnymi wpadkami przy pracy z n8n. Mam nadzieję, że moje potknięcia pomogą Ci uniknąć podobnych pułapek.
Brak walidacji złożonych struktur
Kiedyś zlekceważyłem sprawdzenie poprawności zagnieżdżonego JSON-a, co w efekcie spowodowało czternaście dni opóźnienia w finalnym wdrożeniu projektu. Musiałem ręcznie naprawiać tysiące błędnych rekordów, bo automat bezmyślnie przetworzył puste obiekty. Teraz zawsze weryfikuję strukturę na wejściu, żeby taka historia nigdy się nie powtórzyła.
Nieuwzględnienie specyfiki Item List
Zrobiłem poważny błąd, zakładając, że n8n automatycznie obsłuży głębokie listy w każdym węźle bez odpowiedniego filtrowania. Doprowadziło to do całkowitej utraty zaufania klienta, ponieważ dane wyjściowe były całkowicie pomieszane. Cały proces musiałem przebudować od zera, żeby każdy węzeł pracował na czystych i przewidywalnych danych.
Zbyt duża złożoność w jednym przepływie
Przez zbyt długi czas próbowałem upchnąć całą logikę filtrowania w jednym gigantycznym węźle, zamiast dzielić go na mniejsze kroki. Ta lekcja nauczyła mnie, że modułowość i czytelność procesu są ważniejsze niż krótki workflow. Teraz zawsze rozbijam skomplikowane operacje na mniejsze części, co pozwala mi błyskawicznie wyłapać błąd w konkretnym miejscu.
Podsumowanie
Praca ze strukturami JSON w n8n opiera się na precyzyjnym adresowaniu wartości oraz umiejętnym filtrowaniu zbędnych elementów. Kluczem do sukcesu jest wykorzystanie wbudowanych narzędzi takich jak Item Lists oraz wyrażeń JavaScript, które zamieniają surowe dane w wartościowe informacje dla twoich systemów biznesowych. Pamiętaj, że każda zagnieżdżona tablica to potencjalna pułapka, dlatego zawsze stosuj bezpieczne metody dostępu i weryfikuj typy danych na wejściu. Optymalizacja procesu przesyłania danych nie tylko przyspiesza działanie twoich automatyzacji, ale przede wszystkim znacząco obniża koszty związane z liczbą zapytań do zewnętrznych interfejsów programistycznych. Stosując te metody, budujesz solidne, powtarzalne i odporne na błędy procesy, które mogą skalować się wraz z potrzebami twojej organizacji.
Źródła
- n8n.io/docs/data-transformation
- developer.mozilla.org/en-US/docs/Learn/JavaScript/Objects/JSON
- json.org/json-en.html
- n8n.io/docs/nodes/item-lists
Najczęściej zadawane pytania (FAQ)
Jak przekazać dane JSON między węzłami w n8n?
Dane JSON są przekazywane automatycznie w n8n poprzez standardowy potok danych (workflow). Możesz uzyskać dostęp do poprzedniego węzła, używając wyrażeń JavaScript w polach wejściowych, odwołując się do obiektu `{{ $json }}`.
Jak odfiltrować konkretne pole zagnieżdżonego obiektu JSON w n8n?
Aby wyodrębnić konkretne pole z zagnieżdżonej struktury, najlepiej użyć węzła „Item Lists” lub „Set” z wyrażeniem typu `{{ $json.rodzic.dziecko.pole }}`. Możesz również użyć węzła „Code”, aby przefiltrować strukturę przy pomocy standardowego skryptu JavaScript.
Czy w n8n można użyć węzła „Code” do zaawansowanego filtrowania JSON?
Tak, węzeł „Code” pozwala na pełną manipulację danymi za pomocą języka JavaScript. Jest to idealne rozwiązanie, gdy musisz użyć metod takich jak `.filter()`, `.map()` lub `.reduce()` do przetworzenia złożonych tablic obiektów JSON.
Jak poradzić sobie z błędami przy parsowaniu niepoprawnych struktur JSON w n8n?
Najlepiej zastosować węzeł „Error Trigger” lub skorzystać z opcji „Continue On Fail” w ustawieniach węzła. Warto również użyć bloku „Try-Catch” wewnątrz węzła „Code”, aby obsłużyć wyjątki powstałe podczas nieudanej parsowania formatu.
Jak przekształcić tablicę obiektów JSON na pojedyncze elementy w n8n?
Do tego celu służy węzeł „Item Lists” z ustawioną operacją „Split Out”. Pozwala on rozbić tablicę JSON na osobne elementy, co umożliwia przetwarzanie każdego rekordu z osobna w kolejnych krokach workflow.
Jak w n8n dynamicznie filtrować JSON na podstawie danych z zewnętrznego API?
Możesz pobrać dane z zewnętrznego API węzłem „HTTP Request”, a następnie użyć węzła „Merge” lub „Code”. Węzeł „Code” pozwoli Ci porównać strukturę wejściową z pobranym JSON-em i zwrócić tylko pasujące rekordy.
Czy można filtrować JSON w n8n bez pisania kodu?
Tak, n8n oferuje węzły takie jak „Filter” oraz „Item Lists”, które pozwalają na operacje na danych bez pisania skryptów. Są one wystarczające do prostego filtrowania wartości lub usuwania niepotrzebnych pól z obiektów.
Jak połączyć dwa złożone obiekty JSON w jeden w n8n?
Możesz użyć węzła „Merge” w trybie „Append” lub „Combine”. Jeśli potrzebujesz bardziej zaawansowanej logiki łączenia, węzeł „Code” pozwoli Ci na scalenie obiektów za pomocą operatora spread (`…obj1, …obj2`).
W jaki sposób zmapować pola JSON z jednego formatu na inny w n8n?
Użyj węzła „Set” lub „Edit Fields” (w nowszych wersjach), aby ręcznie przypisać wartości z przychodzącego JSON do nowych kluczy. To rozwiązanie jest czytelne i pozwala na szybką transformację struktury danych przed wysłaniem jej dalej.
Jak przetestować filtrowanie JSON w trakcie budowania workflow?
W edytorze n8n możesz klikać w poszczególne węzły, aby zobaczyć podgląd danych „Input” oraz „Output”. Dzięki temu w czasie rzeczywistym zweryfikujesz, czy Twoje filtry lub wyrażenia działają zgodnie z oczekiwaniami.
Czy węzeł „Code” w n8n obsługuje biblioteki zewnętrzne do pracy z JSON?
Węzeł „Code” obsługuje wbudowane obiekty JavaScript, takie jak `JSON.parse` czy `JSON.stringify`. Wersje n8n self-hosted pozwalają również na importowanie niektórych bibliotek NPM poprzez konfigurację zmiennych środowiskowych.
Jak usunąć puste pola z obiektu JSON w n8n?
Najskuteczniejszą metodą jest użycie węzła „Code” z pętlą, która sprawdza wartości każdego pola w obiekcie. Możesz użyć metody `delete` lub stworzyć nowy obiekt, do którego dodasz tylko klucze z niepustymi wartościami.
Jak przekazać dane JSON do kolejnych węzłów, jeśli struktura jest bardzo głęboka?
W przypadku głębokich struktur, najlepiej stworzyć zmienną tymczasową w węźle „Code”, która spłaszcza obiekt. Dzięki temu dostęp do danych w dalszej części workflow będzie znacznie prostszy i mniej podatny na błędy.
Jaką wydajność ma filtrowanie dużych plików JSON w n8n?
Przetwarzanie bardzo dużych plików JSON w pamięci RAM może spowolnić n8n przy małych instancjach. Jeśli pracujesz z gigantycznymi zbiorami, rozważ przetwarzanie strumieniowe lub ogranicz ilość przesyłanych danych poprzez wczesne filtrowanie na etapie pobierania.
Jakie są najlepsze praktyki w nazywaniu pól JSON podczas ich filtrowania w n8n?
Stosuj czytelne nazewnictwo zgodne z konwencją camelCase i unikaj polskich znaków w kluczach JSON. Dbałość o spójną strukturę danych na wczesnym etapie workflow ułatwi debugowanie i zapewni stabilność całego procesu automatyzacji.