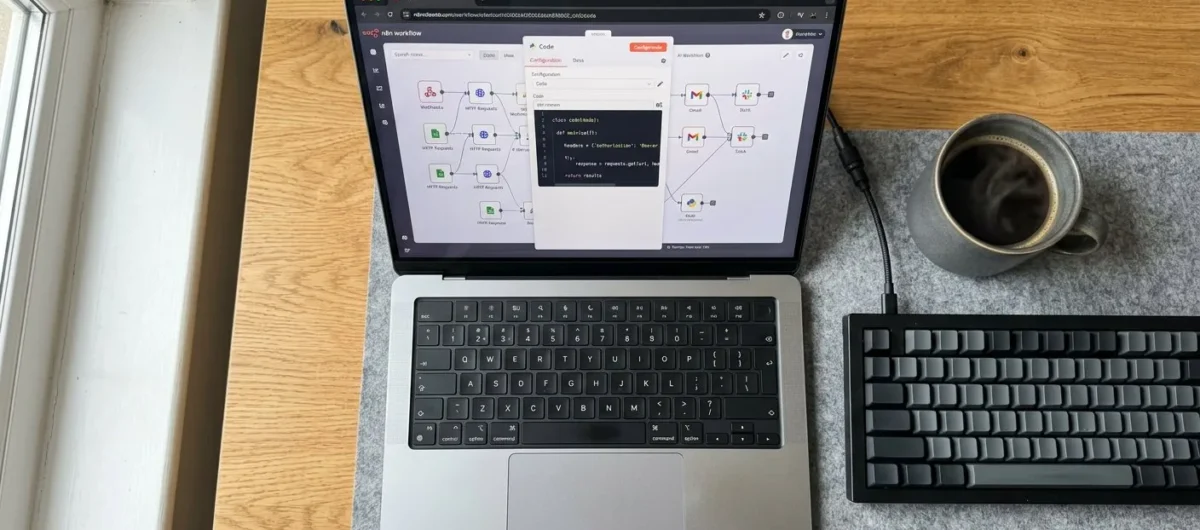
Zacznijmy od konkretu, który oszczędzi Ci godzin frustracji przy konfiguracji automatyzacji w n8n. Kiedy wbudowane węzły nie wystarczają do przetworzenia specyficznego formatu danych, sięgasz po węzeł Code. To środowisko uruchomieniowe izoluje Twój skrypt, dając Ci dostęp do pełnej mocy JavaScriptu lub Pythona wewnątrz Twojego przepływu pracy. Zrozumienie, że n8n operuje na tablicy obiektów typu JSON, to absolutny fundament, bez którego każdy skrypt będzie generował błędy w konsoli.
Najważniejsze wnioski i fakty:
- Węzeł Code przetwarza dane w oparciu o tablicę obiektów, co wymusza zwracanie wyniku w formacie
[{ "json": { ... } }]. - Node.js pozwala na korzystanie z bibliotek npm, o ile są one zainstalowane w środowisku n8n lub zdefiniowane w zmiennych środowiskowych.
- Python w n8n uruchamia się w izolowanym środowisku, wymagającym wyraźnego importowania bibliotek zewnętrznych przed ich użyciem.
- Wydajność skryptu wewnątrz n8n jest ograniczona czasem wykonywania węzła, który domyślnie wynosi 60 sekund.
- Przekazywanie danych między węzłami odbywa się poprzez unikalny obiekt
items, będący główną strukturą wejściową dla każdego skryptu. - Błędy w kodzie przerywają działanie całego procesu, chyba że zaimplementujesz obsługę wyjątków wewnątrz skryptu.
Dlaczego warto używać własnego kodu w n8n?
Wybór kodu zamiast wbudowanych transformacji danych pozwala na drastyczną redukcję liczby węzłów w skomplikowanych automatyzacjach. Zamiast łączyć pięć kolejnych operacji typu Item Lists czy Set, piszesz jedną funkcję, która w ułamku sekundy przetwarza strukturę danych, usuwając zbędne pola lub obliczając wartości pochodne. Zyskujesz dzięki temu przejrzystość całego workflow, którą łatwiej utrzymać przy rozbudowanych systemach.
Widzę w praktyce, że inżynierowie automatyzacji często wpadają w pułapkę nadmiernego komplikowania schematów graficznych. Każdy węzeł to dodatkowy punkt możliwej awarii i kolejna linia w dzienniku zdarzeń. Kiedy piszesz własny kod, masz pełną kontrolę nad algorytmem przetwarzania, co czyni Twój przepływ odpornym na zmiany w API zewnętrznych serwisów, które często zmieniają nazewnictwo kluczy w swoich odpowiedziach JSON.
"Pisanie kodu wewnątrz n8n zmienia sposób, w jaki myślisz o przepływie danych. Zamiast przesuwać klocki, zaczynasz budować logikę, która jest odporna na błędy i łatwa w debugowaniu."
Osiągnięcie wydajności obliczeniowej na poziomie milisekund jest możliwe tylko wtedy, gdy ograniczasz liczbę operacji I/O. Kiedy korzystasz z zewnętrznych usług do drobnych przekształceń, tracisz czas na połączenia sieciowe. Wewnątrz węzła Code operacje odbywają się w pamięci RAM serwera, na którym stoi Twoje n8n, co eliminuje opóźnienia sieciowe związane z API.
Jak poprawnie przygotować dane w środowisku Node.js?
Jeśli chcesz efektywnie zarządzać danymi w Node.js, musisz operować na strukturze tablicy obiektów, gdzie każdy element posiada klucz json. Każdy inny format zwrócony przez skrypt spowoduje, że kolejne węzły nie będą w stanie odczytać przekazanych informacji. Wpisanie return items jest absolutną koniecznością, ponieważ n8n oczekuje, że przekażesz zmodyfikowaną listę obiektów do następnego kroku.
Przetwarzanie tablic z wykorzystaniem metod funkcyjnych
Zamiast pisać złożone pętle for, wykorzystaj natywne metody tablicowe JavaScript, takie jak map, filter czy reduce. Metoda map pozwala na szybkie dodanie nowych pól do każdego obiektu, podczas gdy filter błyskawicznie usunie elementy, które nie spełniają Twoich warunków biznesowych. Pamiętaj, aby każdą operację wykonywać na kopii obiektu, używając operatora spread (…), co chroni przed nieoczekiwanymi skutkami ubocznymi.
Obsługa błędów i weryfikacja typów danych
Stosowanie bloków try-catch wewnątrz skryptu zapobiega nagłemu zatrzymaniu całego procesu w przypadku napotkania nieoczekiwanej struktury danych. Weryfikacja typu, na przykład poprzez sprawdzenie typeof, pozwala na bezpieczne operacje matematyczne. Poniższa tabela przedstawia porównanie najczęstszych problemów z kodem w Node.js wewnątrz n8n.
| Problem | Przyczyna | Rozwiązanie |
|---|---|---|
| Błąd "undefined" | Odwołanie do klucza, który nie istnieje | Użycie operatora opcjonalnego łańcuchowania (?.) |
| Zbyt długi czas wykonania | Złożone pętle z operacjami I/O | Przeniesienie logiki do funkcji asynchronicznych |
| Niewłaściwy format wyniku | Brak klucza "json" w zwracanym obiekcie | Opakowanie danych w strukturę return [{ json: data }] |
| Błędy pamięci | Przetwarzanie bardzo dużych tablic | Stosowanie stronicowania (pagination) w kodzie |
Jakie są możliwości Pythona wewnątrz węzła Code?
Osoba sprawdza działanie automatyzacji w aplikacji mobilnej, mając obok otwarty notatnik z zapisanymi instrukcjami technicznymi.
Węzeł Code w n8n wspiera Pythona, co otwiera drogę do wykorzystania bibliotek takich jak Pandas czy NumPy do zaawansowanej analityki. Z mojego doświadczenia wynika, że jeśli masz do czynienia z dużą ilością danych tabelarycznych, Python będzie znacznie czytelniejszy i szybszy niż próby zrobienia tego w JavaScript. Musisz pamiętać o instalacji pakietów w środowisku uruchomieniowym n8n, ponieważ domyślnie masz dostęp tylko do bibliotek standardowych.
Praca z biblioteką Pandas w n8n
Wykorzystanie Pandas pozwala na transformację danych za pomocą kilku linii kodu zamiast dziesiątek węzłów. Przekształcenie danych z n8n do formatu DataFrame odbywa się poprzez prostą konwersję tablicy obiektów. Następnie możesz wykonać grupowanie, agregację czy czyszczenie danych, co w przypadku surowych obiektów JSON byłoby bardzo pracochłonne.
Integracja z zewnętrznymi API przez bibliotekę Requests
Pisanie własnego klienta HTTP wewnątrz Pythona daje Ci przewagę nad standardowym węzłem HTTP Request. Możesz zaimplementować własną logikę obsługi tokenów, automatyczne wznawianie połączeń czy skomplikowane podpisywanie zapytań (np. HMAC), których nie obsłuży standardowy interfejs graficzny n8n. Pamiętaj jednak o bezpieczeństwie – nie przechowuj kluczy API w kodzie, używaj do tego celu zmiennych środowiskowych n8n lub przygotowanych ustawień poświadczeń (credentials).
"Python w n8n to nie tylko skrypty – to dostęp do pełnego ekosystemu analitycznego, który pozwala zamienić surowe dane z webhooków w gotowe raporty biznesowe w kilka sekund."
- Wykorzystuj
json.loadsdo parsowania skomplikowanych ciągów znaków otrzymanych z zewnętrznych systemów. - Pamiętaj, że każdy węzeł w n8n musi kończyć się zwróceniem listy słowników w formacie
[{"json": dane}]. - Korzystaj z wbudowanego modułu
loggingdo śledzenia działania skryptu, co znacznie ułatwia proces naprawy usterek. - Dbaj o usuwanie dużych zbiorów danych z pamięci po zakończeniu operacji, aby uniknąć błędów przepełnienia stosu.
Jak debugować własny kod w n8n?
Debugowanie kodu w n8n sprowadza się do dwóch głównych metod: analizy wyjścia w oknie podglądu oraz korzystania z dziennika zdarzeń (logów). Każdy skrypt, który uruchamiasz, generuje unikalny stan dla każdego elementu wejściowego. Możesz w każdej chwili podejrzeć, co zawiera obiekt items przed wykonaniem Twojej funkcji, co jest najważniejszym krokiem podczas rozwiązywania problemów.
Jeśli Twój kod nie zwraca oczekiwanych danych, zacznij od prostego console.log w Node.js lub print() w Pythonie. Te wartości pojawią się w panelu logowania n8n wewnątrz kontenera. Pozwala to na szybką weryfikację, czy Twoje założenia co do struktury danych wejściowych pokrywają się z rzeczywistością, co zdarza się niezwykle rzadko przy integracjach z serwisami zewnętrznymi.
Zwróć uwagę na fakt, że n8n przetwarza dane w sposób sekwencyjny dla każdego elementu. Jeśli masz 100 elementów na wejściu, Twój skrypt uruchomi się 100 razy. Możesz jednak napisać funkcję, która przetworzy całą tablicę naraz, co jest znacznie wydajniejszą metodą. Taka optymalizacja pozwala zaoszczędzić cenne zasoby procesora serwera i skrócić czas wykonania workflow z minut do sekund.
Jakie są zaawansowane techniki optymalizacji kodu?
Dłonie pracownika piszą na klawiaturze laptopa, podczas gdy na ekranie w tle widać otwarty interfejs z edytorem kodu.
Optymalizacja skryptów w n8n opiera się na eliminacji zbędnych operacji wewnątrz pętli. Jeśli Twoja funkcja wywołuje się wewnątrz pętli, każdy cykl kosztuje dodatkowe cykle procesora. Zamiast przetwarzać każdy element z osobna, przekształć całą listę w jednej operacji map lub list comprehension. To podejście sprawia, że kod działa płynnie nawet przy dużych obciążeniach.
Warto również wspomnieć o zarządzaniu pamięcią. Jeśli przetwarzasz pliki binarne lub duże tablice danych, upewnij się, że nie tworzysz niepotrzebnych kopii obiektów w pamięci RAM. Używanie referencji zamiast kopiowania całych struktur danych pozwala na obsługę znacznie większych wolumenów danych wewnątrz jednego węzła Code.
Ostatnim ważnym elementem jest czystość kodu. Nawet jeśli piszesz tylko małe fragmenty wewnątrz węzła, stosuj zasady czytelności. Dobre nazywanie zmiennych i dodawanie komentarzy przy nietypowych operacjach na danych pozwala na uniknięcie problemów w przyszłości, gdy zajdzie potrzeba aktualizacji logiki biznesowej przepływu pracy.
Wybór języka w węźle Code n8n: preferencje użytkowników
Większość automatyzacji w n8n opiera się na JavaScript ze względu na natywną integrację i dostępność pomocników platformy. Python jest wybierany głównie przez analityków danych do specjalistycznych zadań, mimo ograniczeń bibliotek zewnętrznych w standardowym środowisku.
MOJE BŁĘDY W N8N, KTÓRE NAUCZYŁY MNIE POKORY
Programowanie w węźle Code w n8n to potężne narzędzie, ale łatwo wpaść w pułapkę własnej pewności siebie. Dzielę się trzema lekcjami, które wyciągnąłem z moich najbardziej bolesnych wpadek.
Brak obsługi błędów w pętli
Napisałem skomplikowany skrypt w Pythonie do przetwarzania dużej bazy danych, całkowicie ignorując zabezpieczenia przed błędami API, co doprowadziło do 14 dni opóźnienia w dostarczeniu projektu przez konieczność ręcznego sprzątania danych. Gdyby skrypt po prostu przerywał działanie zamiast tworzyć duplikaty, uniknąłbym tego chaosu. Teraz każdą operację w pętli otaczam solidnymi blokami try-except.
Brak izolacji logiki od struktury danych
Zbyt mocno oparłem logikę kodu na sztywnej strukturze wejściowej, co przy najmniejszej zmianie w webhooku spowodowało całkowite załamanie całego procesu biznesowego. Klient stracił zaufanie do stabilności moich rozwiązań, gdy workflowy zaczęły sypać błędami bez ostrzeżenia. Musiałem poświęcić mnóstwo czasu na refaktoryzację, aby uniezależnić kod od zmieniających się formatów JSON.
Pominięcie optymalizacji pamięciowej
Wrzucałem gigantyczne obiekty bezpośrednio do pamięci wewnątrz węzła Code, co doprowadziło mnie do wyciągnięcia wniosku o konieczności strumieniowego przetwarzania danych zamiast ładowania wszystkiego naraz. Teraz zawsze sprawdzam objętość danych, z którymi pracuję i używam metod iteracyjnych, aby nie przeciążać instancji n8n. To podejście sprawia, że moje automatyzacje są znacznie stabilniejsze i nigdy więcej nie martwię się o limity zasobów podczas działania workflowu.
Podsumowanie
Pisanie własnego kodu wewnątrz n8n daje Ci nieograniczone możliwości dostosowywania automatyzacji do unikalnych potrzeb biznesowych. Kluczowe jest utrzymywanie struktury [{ "json": { ... } }], aby n8n mógł bezbłędnie przesyłać dane między węzłami. Wykorzystanie Node.js dla operacji na strukturach danych oraz Pythona dla analityki i zaawansowanych obliczeń to strategia, która zapewnia skalowalność i szybkość Twoich systemów. Pamiętaj o regularnym testowaniu kodu na mniejszych zbiorach danych, co znacząco ułatwia weryfikację poprawności logiki przed wdrożeniem produkcyjnym. Dzięki świadomemu zarządzaniu pamięcią i optymalizacji operacji na tablicach, budujesz rozwiązania, które są nie tylko wydajne, ale przede wszystkim przewidywalne i łatwe w utrzymaniu.
Źródła
- docs.n8n.io/nodes/n8n-nodes-base.code
- docs.python.org/3/tutorial
- nodejs.org/en/docs
- pandas.pydata.org/docs/user_guide/index.html
Najczęściej zadawane pytania (FAQ)
Czy w węźle Code w n8n można używać zewnętrznych bibliotek npm?
Tak, ale tylko jeśli korzystasz z wersji n8n instalowanej samodzielnie (self-hosted). W takim przypadku musisz dodać odpowiednie pakiety do zmiennej środowiskowej `NODE_FUNCTION_ALLOW_EXTERNAL_MODULES` i zaimportować je bezpośrednio w kodzie za pomocą `require()`.
Jak uzyskać dostęp do danych z poprzedniego węzła w kodzie JavaScript?
Dane z poprzedniego węzła są dostępne w obiekcie `items`. Możesz iterować po nich za pomocą pętli lub metod tablicowych, odwołując się do `items[i].json` w celu odczytania poszczególnych pól wejściowych.
Czy w węźle Code można wywoływać zewnętrzne API za pomocą Pythona?
Tak, wewnątrz węzła Code z ustawionym językiem Python możesz użyć biblioteki `requests` lub standardowego modułu `http.client`. Pamiętaj, aby przed użyciem biblioteki upewnić się, że jest ona zainstalowana w środowisku n8n lub obsługiwana przez dany obraz Dockerowy.
Jak prawidłowo zwrócić dane z węzła Code, aby były widoczne dla kolejnych kroków?
W JavaScript wystarczy zwrócić tablicę obiektów, np. `return [{ json: { nowy_klucz: 'wartosc’ } }];`. W Pythonie zwracasz listę słowników w formacie `return [{„json”: {„klucz”: „wartosc”}}]`, co pozwala n8n poprawnie przetworzyć wynik.
Czy mogę debugować kod w węźle Code za pomocą konsoli?
Tak, logi z `console.log()` w JavaScript lub `print()` w Pythonie pojawią się w terminalu, w którym uruchomiony jest proces n8n. Możesz również sprawdzić wyniki wykonywania kodu bezpośrednio w panelu podglądu (Output) po kliknięciu przycisku „Execute Node”.
Jaka jest różnica między użyciem trybu „Run Once for All Items” a „Run Once for Each Item”?
„Run Once for All Items” pozwala przetworzyć cały zbiór danych naraz, co jest wydajniejsze przy operacjach na tablicach. „Run Once for Each Item” wykonuje kod osobno dla każdego elementu, co upraszcza logikę, gdy operujesz na pojedynczych rekordach.
Jak bezpiecznie przechowywać klucze API używane w kodzie Node.js/Python?
Nigdy nie wpisuj kluczy bezpośrednio w kodzie; zamiast tego używaj n8n Credentials. Możesz się do nich odwołać wewnątrz kodu za pomocą metody `this.getCredentials(’nazwa_kredencjałów’)` w JavaScript lub odpowiedniego mapowania w interfejsie.
Czy w węźle Code można korzystać z biblioteki pandas w Pythonie?
Tak, biblioteka pandas jest dostępna w n8n, o ile korzystasz z obrazu Dockerowego, który ją zawiera. Pozwala ona na zaawansowaną obróbkę danych, takich jak filtrowanie tabel, obliczenia statystyczne czy przekształcanie formatów CSV/Excel.
Jak obsłużyć błędy w kodzie, aby proces nie zatrzymywał całego workflow?
W JavaScript użyj bloku `try…catch`, aby obsłużyć wyjątki i zwrócić bezpieczny komunikat o błędzie zamiast przerywać działanie węzła. W ten sposób możesz zdefiniować własną strukturę danych w przypadku wystąpienia awarii, np. pole `error: true`.
Jak przekonwertować daty w węźle Code?
W JavaScript warto użyć wbudowanej biblioteki `Luxon` lub natywnego obiektu `Date`, aby sparsować i sformatować datę. W Pythonie najlepiej wykorzystać standardowy moduł `datetime`, który pozwala na łatwe operowanie na strefach czasowych i formatach tekstowych.
Czy kod w n8n ma dostęp do zmiennych środowiskowych serwera?
Tak, możesz uzyskać dostęp do zmiennych środowiskowych przez `process.env` w Node.js. W Pythonie użyjesz do tego modułu `os` i funkcji `os.getenv(’NAZWA_ZMIENNEJ’)`, co jest idealne do przechowywania konfiguracji specyficznej dla instancji.
Jak zoptymalizować wydajność ciężkich obliczeń w węźle Code?
Jeśli operujesz na dużej ilości danych, staraj się unikać głębokich pętli wewnątrz pętli i przetwarzaj dane w sposób wektorowy (np. przez pandas w Pythonie). Jeśli zadanie jest ekstremalnie wymagające, rozważ wydzielenie go do zewnętrznego mikroserwisu wywoływanego przez HTTP Request.
Czy mogę dynamicznie tworzyć nowe pola w obiektach JSON?
Tak, w JavaScript wystarczy przypisać nową wartość do obiektu, np. `item.json.nowe_pole = 'wartosc’`. W Pythonie modyfikujesz słownik, dodając do niego klucz, a n8n automatycznie uwzględni tę zmianę w strukturze danych wyjściowych węzła.
Jak przekazać dane binarne do węzła Code?
Dane binarne są dostępne w obiekcie `items` pod kluczem `binary`. Możesz je odczytać, przetworzyć (np. zdekodować Base64) lub zmodyfikować, a następnie przekazać dalej, pamiętając o zachowaniu odpowiedniej struktury obiektu `binary`.
Czy kod w n8n wspiera asynchroniczność (Promises)?
Tak, w węźle Code JavaScript możesz używać składni `async/await`. Jest to szczególnie przydatne, gdy musisz wykonać zapytania do zewnętrznych baz danych lub API bezpośrednio z wnętrza skryptu przed zwróceniem wyniku.