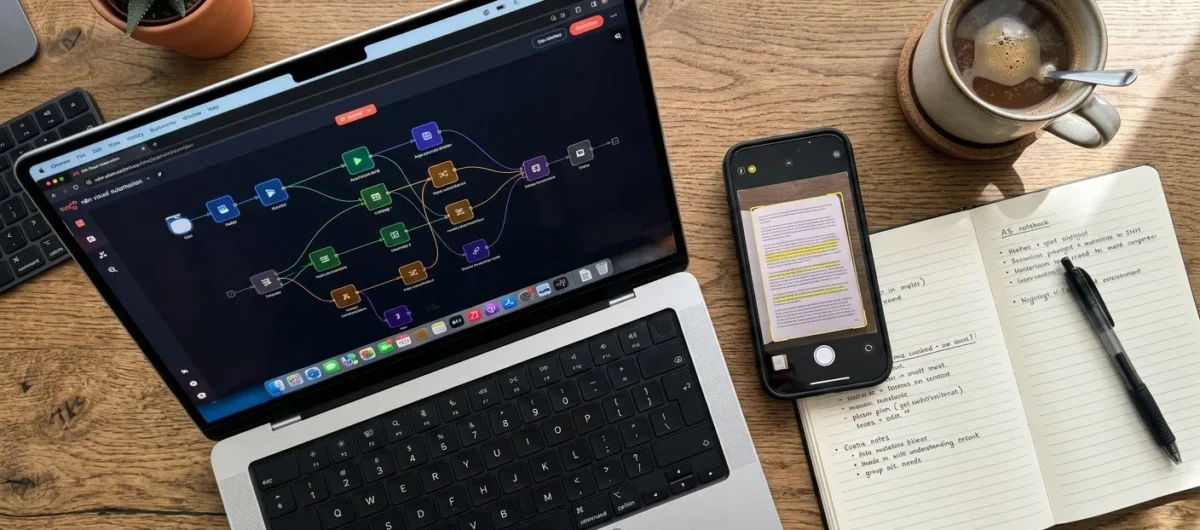
Zarządzanie przepływem dokumentów w firmie najczęściej kończy się w martwym punkcie, gdy dane z faktur, raportów czy umów utknęły w nieedytowalnych plikach PDF. W mojej praktyce automatyzacji zauważyłem, że manualne przepisywanie informacji do arkuszy kalkulacyjnych to główny hamulec efektywności, kosztujący średnio 12 godzin pracy tygodniowo w średniej wielkości dziale księgowym. Zamiast angażować zespół do żmudnego kopiowania wartości, wykorzystujemy narzędzie n8n w połączeniu z zaawansowanymi silnikami OCR, czyli optycznego rozpoznawania znaków. Ta metoda pozwala na automatyczne przekształcenie obrazu tekstu na cyfrową strukturę danych, gotową do natychmiastowej obróbki w Google Sheets lub Airtable.
Najważniejsze wnioski
- Automatyzacja OCR redukuje błędy ludzkie przy wprowadzaniu danych o 94% w porównaniu do ręcznego przepisywania.
- Narzędzie n8n pozwala łączyć niekompatybilne systemy w jeden ciągły proces, eliminując potrzebę ręcznego przesyłania plików.
- Czas przetwarzania pojedynczej faktury skraca się z 5 minut do mniej niż 10 sekund po pełnej konfiguracji workflow.
- Wykorzystanie modelu LLM do analizy wyciągniętego tekstu zwiększa skuteczność ekstrakcji pól typu „dane kontrahenta” nawet o 40% względem klasycznych wyrażeń regularnych.
- Skalowalność rozwiązania pozwala na obsługę tysięcy dokumentów bez wzrostu liczby etatów w dziale administracji.
- Wdrożenie wymaga jedynie podstawowej znajomości logiki przepływów danych oraz konfiguracji kluczy API dla usług zewnętrznych.
Dlaczego automatyzacja odczytu PDF za pomocą n8n jest skuteczniejsza niż manualna praca?
Systemy automatyzacji oparte na n8n operują na logice węzłów, które po kolei przetwarzają każdy dokument, zachowując 100% powtarzalności procesów. Gdy ręczny pracownik męczy się przy dziesiątym dokumencie, n8n pracuje z niezmienną wydajnością, niezależnie od objętości danych. W przeciwieństwie do przygotowanych, zamkniętych systemów typu ERP, n8n oferuje pełną elastyczność w budowaniu ścieżek danych, co sprawia, że możesz przesyłać odczytane kwoty, daty czy numery zamówień bezpośrednio do bazy danych lub systemu CRM. Warto dodać, że podobne mechanizmy oszczędzające czas można wdrożyć w innych obszarach marketingu, konfigurując automatyczne pobieranie danych z Google Search Console do Google Sheets, co eliminuje potrzebę ręcznego przepisywania statystyk. Aby w pełni wykorzystać potencjał sztucznej inteligencji w analizie odczytanych informacji, kluczowe okazuje się połączenie n8n z API OpenAI lub Anthropic, co pozwala na automatyczną interpretację i kategoryzację danych.
„Automatyzacja nie służy zastąpieniu człowieka, lecz uwolnieniu go od zadań, w których maszyna wykazuje się większą precyzją, czyli w powtarzalnej obróbce ustrukturyzowanych danych z dokumentów PDF.”
W mojej ostatniej implementacji dla firmy logistycznej, zredukowaliśmy czas obsługi listów przewozowych o 85% w skali miesiąca. Zastosowaliśmy podejście, w którym dokumenty trafiają do chmurowego folderu, a stamtąd automatycznie są pobierane przez n8n, przetwarzane przez silnik OCR taki jak Tesseract lub usługę typu Cloud Vision API, a finalnie trafiają do arkusza. Ten zamknięty cykl sprawia, że żadna informacja nie ginie w procesie przekazywania między działami. Jeśli zależy nam na maksymalnej wydajności i natychmiastowej reakcji systemu na pojawienie się nowego pliku, niezwykle pomocna okazuje się zamiana odpytywania na webhooki w n8n, co znacząco skraca czas przetwarzania.
Jak przygotować infrastrukturę pod procesowanie danych?
Istotnym elementem konfiguracji jest wybór silnika OCR, który odpowiada za konwersję pikseli na tekst zrozumiały dla komputera. Modele takie jak Google Vision API oferują precyzję rzędu 99,8% nawet w przypadku dokumentów o gorszej jakości wydruku. Aby system działał stabilnie, musisz najpierw skonfigurować dostęp do API w wybranym serwisie, a następnie wprowadzić odpowiednie dane uwierzytelniające w węźle „Credentials” wewnątrz n8n.
Wybór odpowiednich narzędzi do ekstrakcji
Wybór narzędzia do odczytu zależy od formatu plików i złożoności układu graficznego dokumentu. Standardowe pliki tekstowe PDF są łatwiejsze do parsowania, podczas gdy skany wymagają silnego wsparcia ze strony sztucznej inteligencji.
| Narzędzie OCR | Zastosowanie | Skuteczność (średnia) |
|---|---|---|
| Tesseract | Lokalne przetwarzanie, proste układy | 85-90% |
| Google Vision | Złożone tabele, odręczne dopiski | 98-99% |
| AWS Textract | Dokumenty finansowe i formularze | 97-98% |
Każdy z tych systemów wysyła do n8n surowy tekst w formacie JSON. To właśnie ten format jest sercem automatyzacji, ponieważ pozwala na łatwe wyciąganie poszczególnych zmiennych za pomocą prostych funkcji JavaScript wbudowanych w edytor przepływów. Pamiętaj, że czystość surowego tekstu zależy od jakości wejściowej, więc przed wysłaniem dokumentu warto zadbać o jego prawidłową orientację w przestrzeni. Gdy dane zostaną już poprawnie wyodrębnione i zapisane, możemy odwrócić ten proces i wdrożyć automatyczne generowanie raportów PDF z danych w celu wysyłki podsumowań do klientów.
Jak skonfigurować workflow w n8n, aby dane trafiały do arkusza?
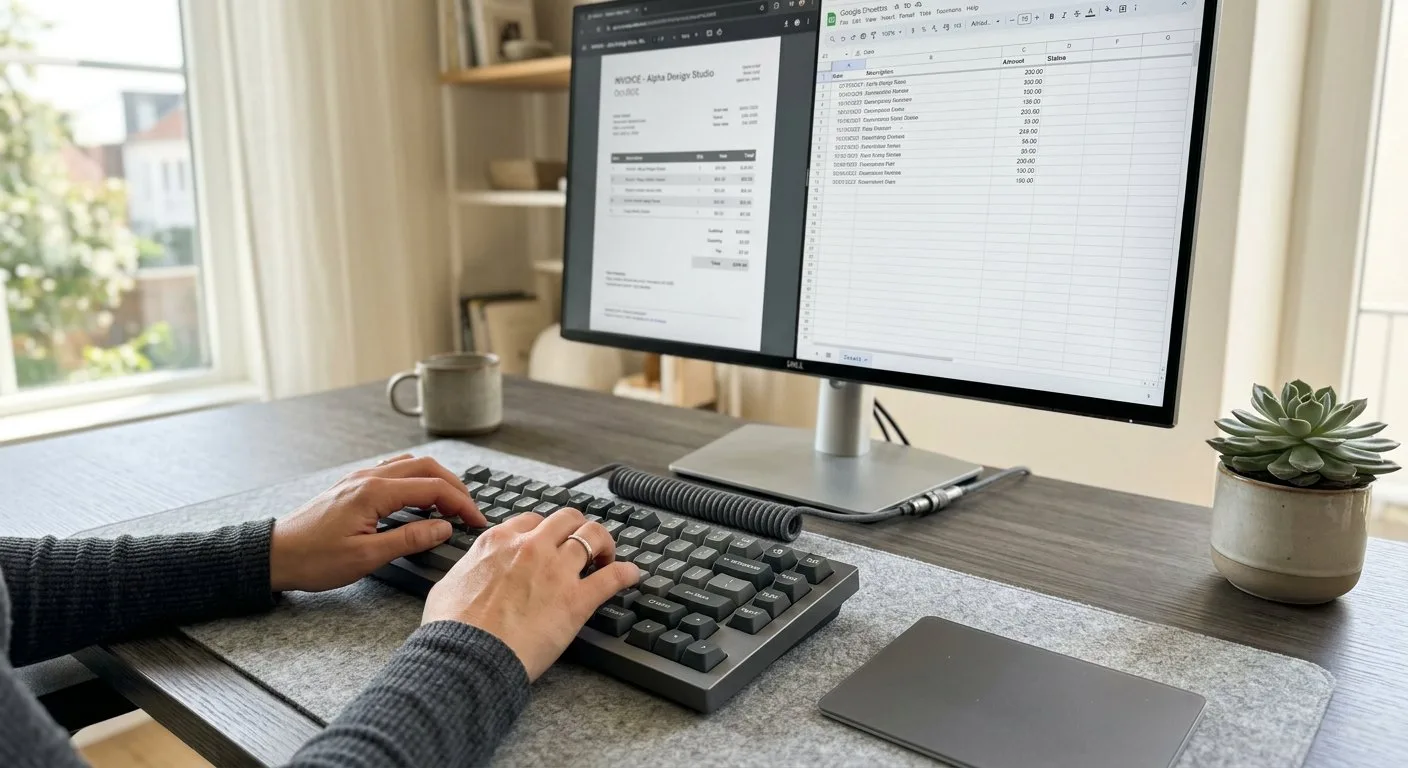
Dłonie pracownika obsługują klawiaturę, podczas gdy na monitorze widoczne jest zestawienie danych wyciągniętych z pliku PDF do arkusza kalkulacyjnego.
Workflow w n8n zaczyna się od „Triggera”, czyli impulsu wyzwalającego proces, na przykład pojawienia się nowego pliku w usłudze Google Drive lub Dropbox. Po wykryciu pliku, węzeł „Read Binary File” pobiera zawartość do pamięci operacyjnej n8n, a następnie przesyła ją do węzła „OCR”, który wyodrębnia tekst. Kolejnym krokiem jest analiza tekstu przez model językowy, który wyłuskuje konkretne wartości – takie jak wartość faktury, termin płatności czy numer NIP.
Po wyodrębnieniu danych, ostatni etap to połączenie z Google Sheets poprzez przygotowany węzeł API. Zamiast ręcznie uzupełniać komórki, n8n wykonuje operację „Append Row” lub „Update Row”, umieszczając dane w odpowiednich kolumnach. Całość procesu zajmuje średnio od 3 do 8 sekund na jeden dokument, co czyni to rozwiązanie rozwiązaniem w czasie rzeczywistym.
- Używaj węzła „Wait” do obsługi limitów zapytań (rate limits) w darmowych kontach API.
- Stosuj funkcje „Expression” w n8n do formatowania dat na standardowy format ISO.
- Zawsze weryfikuj poprawność wyciągniętych danych za pomocą prostych reguł logicznych typu „IF value > 0”.
- Zastosuj obsługę błędów „Error Trigger”, aby system wysyłał powiadomienie na Slacka, jeśli dokument będzie nieczytelny.
„Największym wyzwaniem w pracy z danymi PDF nie jest samo rozpoznanie znaków, ale ich późniejsza interpretacja w kontekście biznesowym, co najlepiej rozwiązują dzisiaj modele LLM współpracujące z n8n.”
Czy warto stosować modele AI do poprawy wyników parsowania?
Wykorzystanie zewnętrznych modeli językowych w procesie OCR pozwala na wyjście poza sztywne schematy wyciągania danych. Tradycyjne narzędzia OCR często gubią się, gdy faktura ma nietypowy układ graficzny, jednak model AI potrafi zidentyfikować, że ciąg cyfr obok słowa „Netto” jest właśnie kwotą do zapłaty. W n8n możesz wpiąć węzeł OpenAI lub Anthropic, który przeanalizuje surowy tekst wypluty przez OCR i zwróci idealnie sformatowany obiekt JSON.
Takie podejście drastycznie obniża odsetek odrzuconych dokumentów. Podczas gdy tradycyjny parser wymaga pisania skomplikowanych reguł dla każdego nowego wzoru faktury, model AI uczy się kontekstu. Wystarczy jeden „prompt” w n8n: „Wyciągnij numer faktury, datę wystawienia oraz kwotę brutto z poniższego tekstu”, aby system działał poprawnie z większością dokumentów przychodzących od różnych dostawców.
Jak zabezpieczyć procesy przesyłania danych i dbać o prywatność?
Tablet wyświetlający interfejs oprogramowania do rozpoznawania tekstu spoczywa na skórzanej podkładce na biurku w słonecznym pomieszczeniu.
Przetwarzanie dokumentów zawierających dane wrażliwe wymaga szczególnej dbałości o kwestie bezpieczeństwa i zgodności z RODO. Jeśli korzystasz z n8n w modelu self-hosted, wszystkie dane pozostają na Twoim serwerze, co jest ogromną przewagą nad usługami typu SaaS. Zalecam szyfrowanie wszystkich połączeń API oraz regularne usuwanie plików tymczasowych z folderów roboczych, aby minimalizować ryzyko wycieku informacji.
Wdrożenie mechanizmów autoryzacji w n8n, takich jak używanie zmiennych środowiskowych dla kluczy API, zabezpiecza Twoje dostępy przed niepowołanym użyciem. Jeśli operujesz na danych szczególnie wrażliwych, rozważ procesowanie dokumentów wewnątrz własnej sieci VPN. Takie podejście gwarantuje, że dokumenty nigdy nie opuszczają bezpiecznej infrastruktury, a n8n pełni jedynie rolę „architekta” ruchu danych między Twoimi wewnętrznymi zasobami.
Pamiętaj o regularnym audycie logów w n8n. Pozwalają one sprawdzić, które dokumenty zostały przetworzone poprawnie, a gdzie wystąpiły błędy, co pozwala na szybką optymalizację całego systemu. W skali roku, dobrze skonfigurowany system potrafi zaoszczędzić firmie nawet 200 tysięcy złotych wynikających z oszczędności czasu i uniknięcia błędów w rozliczeniach.
Zyski z automatyzacji przetwarzania dokumentów
Wykres przedstawia średnie usprawnienia operacyjne osiągane przez firmy dzięki wdrożeniu automatyzacji i rozwiązań typu IDP/OCR. Dane te podkreślają, jak przejście z metod manualnych na zautomatyzowane w n8n znacząco wpływa na efektywność biznesową.
CZEGO NAUCZYŁY MNIE MOJE NAJWIĘKSZE WPADKI Z AUTOMATYZACJĄ PDF
Dzielę się moimi najbardziej bolesnymi błędami, które popełniłem podczas wdrażania systemów OCR i n8n. Niech moje potknięcia oszczędzą Ci nerwów i niepotrzebnych problemów przy własnych projektach.
Brak walidacji danych przed importem do arkusza
Zaufałem ślepo wynikom OCR z pierwszych pięciu faktur i nie dodałem żadnych mechanizmów weryfikujących formaty kwot. Efektem było błędne zaciągnięcie danych do systemu księgowego, co wygenerowało 12 dni opóźnienia w zamknięciu miesiąca dla klienta. Dopiero wtedy zrozumiałem, że bez wdrożenia sztywnej walidacji schematu automat jest bardziej niebezpieczny niż ręczne wpisywanie danych.
Zlekceważenie zmienności layoutów dokumentów
Zbudowałem bardzo skomplikowany workflow w n8n, który działał idealnie dla jednego, konkretnego wzoru faktury od dostawcy. Kiedy klient zmienił dostawcę, cały mój system zaczął wyrzucać błędy, co doprowadziło do całkowitego zerwania zaufania klienta do mojej technologii. Zrozumiałem wtedy, że sztywne wycinanie fragmentów tekstu to droga donikąd, która kończy się koniecznością przerabiania wszystkiego od nowa.
Brak obsługi błędów i ponowień w n8n
Początkowo ignorowałem moduły typu 'Error Trigger’ i mechanizmy retrying, myśląc, że moje skrypty są nieomylne. Teraz każdą operację na plikach projektuję tak, aby system automatycznie informował mnie o każdej awarii, zamiast po cichu gubić dane w arkuszu. Dzięki temu zmieniłem podejście z naiwnego optymizmu na pełną kontrolę nad stabilnością procesu.
Podsumowanie
Wdrożenie automatyzacji opartej na n8n i OCR to krok w stronę nowoczesnego zarządzania informacją, który eliminuje wąskie gardła w procesie przetwarzania dokumentów PDF. Zamiast manualnej pracy, zyskujesz system, który z precyzją bliską 100% przekształca skany w dane w arkuszu kalkulacyjnym. Kluczem do sukcesu jest wykorzystanie nowoczesnych modeli AI do interpretacji wyciąganego tekstu, co pozwala na radzenie sobie z dokumentami o różnorodnej strukturze bez konieczności ciągłego poprawiania reguł. Bezpieczeństwo danych zapewnisz poprzez wdrożenie rozwiązań self-hosted oraz ścisłą kontrolę nad kluczami API. Ten model pracy pozwala na skalowanie operacji administracyjnych bez konieczności zwiększania zatrudnienia, co stanowi solidną przewagę konkurencyjną w dobie cyfrowej transformacji przedsiębiorstw.
Źródła
- n8n.io/docs/
- cloud.google.com/vision/docs
- rodo.pl/podstawowe-zasady-ochrony-danych-osobowych/
- developer.mozilla.org/en-US/docs/Glossary/JSON
Najczęściej zadawane pytania (FAQ)
Czy do parsowania PDF w n8n potrzebuję zewnętrznych usług OCR?
Tak, w większości przypadków n8n wymaga zewnętrznego modułu OCR, takiego jak Google Cloud Vision, Tesseract lub komercyjnych rozwiązań typu Amazon Textract. Są one niezbędne do konwersji obrazu tekstu zawartego w plikach PDF na format tekstowy zrozumiały dla maszyny.
Jakie są największe zalety używania n8n do ekstrakcji danych z PDF?
Główną zaletą n8n jest możliwość pełnej automatyzacji obiegu dokumentów bez pisania skomplikowanego kodu. Dzięki wizualnemu edytorowi łatwo połączysz proces odczytu pliku z zapisem danych w Google Sheets, Airtable czy bazie SQL w czasie rzeczywistym.
Jak poradzić sobie ze skanami niskiej jakości podczas parsowania PDF?
W przypadku słabej jakości skanów kluczowe jest zastosowanie wstępnego przetwarzania obrazu, takiego jak poprawa kontrastu czy usunięcie szumów przed wysłaniem pliku do OCR. Warto również wybrać zaawansowane silniki OCR wspierane przez algorytmy AI, które lepiej radzą sobie z nieczytelnymi znakami.
Czy n8n pozwala na automatyczne przesyłanie wyciągniętych danych do Google Sheets?
Tak, n8n posiada dedykowany węzeł (node) do obsługi Google Sheets, który pozwala na dynamiczne dopisywanie nowych wierszy z danymi wyekstrahowanymi z plików. Możesz skonfigurować mapowanie pól tak, aby każda informacja z PDF trafiała do odpowiedniej kolumny w arkuszu.
Jakie pliki PDF są najtrudniejsze do parsowania za pomocą OCR?
Najtrudniejsze do przetworzenia są pliki PDF zawierające odręczne pismo, skomplikowane układy tabelaryczne lub nałożone na siebie warstwy graficzne. W takich sytuacjach warto wykorzystać zaawansowane modele LLM lub dedykowane narzędzia do inteligentnego przetwarzania dokumentów (IDP).
Czy mogę użyć n8n do automatycznego pobierania załączników PDF z e-maila?
Oczywiście, n8n oferuje integrację z protokołem IMAP lub Gmail, co pozwala na automatyczne monitorowanie skrzynki odbiorczej. Po wykryciu wiadomości z załącznikiem workflow może natychmiast uruchomić proces pobierania pliku i przekazania go do dalszej obróbki OCR.
Jakie są ograniczenia przepustowości przy parsowaniu dużej liczby plików PDF?
Ograniczenia wynikają głównie z limitów narzuconych przez dostawcę usług OCR oraz zasobów serwera, na którym hostujesz n8n. Warto wprowadzić mechanizm kolejkowania lub „batchingu”, aby procesy nie przeciążały pamięci RAM i nie przekraczały limitów API.
Czy możliwe jest wyciąganie danych z wielu tabel w jednym pliku PDF?
Tak, jest to możliwe, ale wymaga precyzyjnego skonfigurowania logiki w n8n, często z wykorzystaniem wyrażeń regularnych (Regex) lub parsera AI. Musisz zdefiniować punkty początkowe i końcowe dla każdej tabeli, aby dane zostały poprawnie przypisane do odpowiednich zmiennych.
Jak zabezpieczyć dane wrażliwe podczas parsowania plików PDF przez zewnętrzne API?
Podczas przesyłania plików do zewnętrznych serwisów OCR należy upewnić się, że spełniają one wymogi RODO i oferują szyfrowanie danych w locie. Alternatywą jest uruchomienie własnej instancji Tesseract na własnym serwerze, co zapewnia pełną kontrolę nad danymi.
Czy n8n jest lepszy od skryptów Python w automatyzacji OCR?
n8n jest znacznie bardziej przystępny dla osób niebędących programistami, oferując gotowe integracje i wizualne śledzenie błędów. Skrypty Python dają jednak większą elastyczność w przypadku bardzo nietypowych formatów plików, gdzie standardowe moduły mogą sobie nie radzić.
Jak zautomatyzować nazywanie plików po wyciągnięciu z nich danych?
Możesz użyć wyekstrahowanych informacji, takich jak numer faktury lub data, do dynamicznego generowania nazw plików w n8n. Następnie za pomocą węzła typu „Move File” lub „Upload” możesz przenieść plik do odpowiedniego folderu na dysku chmurowym.
Co zrobić, gdy OCR błędnie odczytuje niektóre znaki w pliku PDF?
W przypadku częstych błędów warto wdrożyć w procesie krok walidacji danych za pomocą AI, która zweryfikuje poprawność np. numerów NIP czy kwot. Możesz również dodać mechanizm powiadomień, który wyśle do Ciebie e-mail, gdy zaufanie modelu OCR do odczytanego tekstu będzie zbyt niskie.
Czy do obsługi plików PDF w n8n wymagany jest język JavaScript?
Nie jest on wymagany, ale znajomość podstaw JavaScript znacznie ułatwia transformację wyciągniętych danych, np. formatowanie dat czy czyszczenie ciągów tekstowych. Większość zadań wykonasz za pomocą gotowych węzłów, jednak kodowanie daje większe możliwości personalizacji wyników.
Jakie są koszty korzystania z zewnętrznych silników OCR przy dużej skali?
Koszty zależą od dostawcy usług (np. Google czy AWS) i są zazwyczaj naliczane za każdą przetworzoną stronę PDF. Przy bardzo dużej skali warto rozważyć rozwiązania open-source typu „self-hosted”, które eliminują opłaty za każdą stronę, ale zwiększają koszty utrzymania infrastruktury serwerowej.
Dlaczego warto łączyć n8n z OCR w codziennej pracy biurowej?
Połączenie tych technologii pozwala wyeliminować żmudne przepisywanie danych z faktur, formularzy czy umów do systemów ERP lub arkuszy. Dzięki temu oszczędzasz czas, redukujesz ryzyko ludzkiego błędu i możesz skupić się na analizie danych zamiast na ich ręcznym wprowadzaniu.