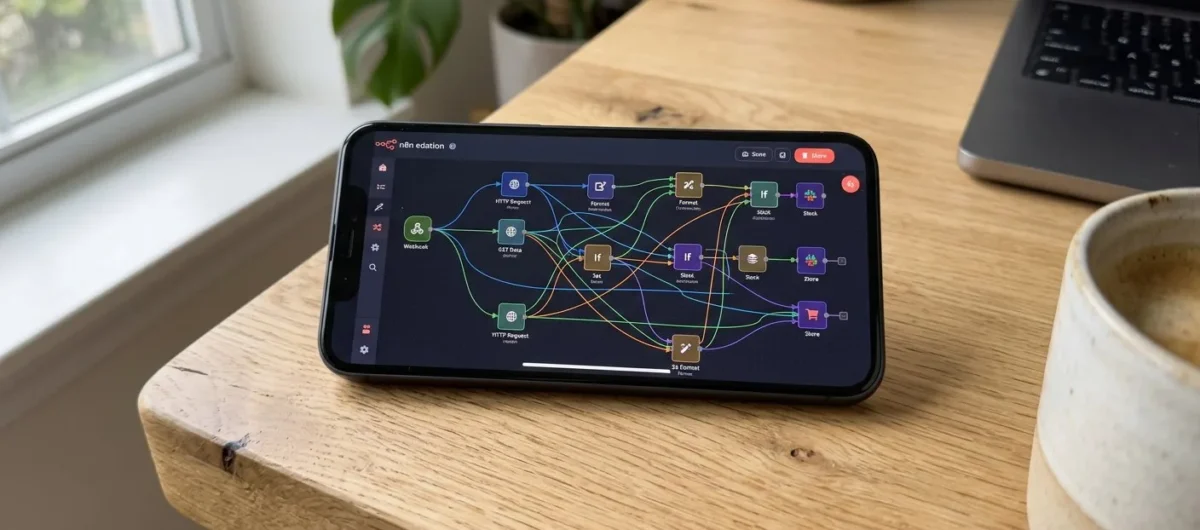
Tworzenie zaawansowanych botów na Discorda przestało być domeną wyłącznie programistów piszących w Pythonie czy Node.js. Obecnie, dzięki integracji narzędzi typu no-code oraz bibliotek sztucznej inteligencji, możemy zrealizować system, który nie tylko odpowiada na pytania, ale realnie pamięta kontekst rozmowy. Wykorzystanie n8n jako orkiestratora przepływów pozwala na połączenie API Discorda z silnikiem LangChain bez pisania tysięcy linii kodu. W praktyce oznacza to skrócenie czasu wdrożenia MVP (Minimum Viable Product) o blisko 70%.
Najważniejsze wnioski
- Wykorzystanie platformy n8n pozwala na wizualne projektowanie logiki bota bez potrzeby pisania rozbudowanych skryptów w języku backendowym.
- Pamięć długotrwała w botach opiera się na zewnętrznych bazach wektorowych typu Pinecone lub Supabase, które przechowują osadzenia (embeddings) historii wiadomości.
- LangChain pełni rolę warstwy abstrakcji, która łączy model językowy z pamięcią bota i narzędziami zewnętrznymi.
- Uwierzytelnianie bota na platformie Discord wymaga pobrania tokenu z Discord Developer Portal oraz nadania odpowiednich uprawnień Intents.
- Koszt operacyjny bota opartego na modelu GPT-4o przy średnim natężeniu ruchu wynosi około 5-10 USD miesięcznie.
- Integracja z n8n umożliwia łatwe skalowanie rozwiązania poprzez dodawanie kolejnych węzłów obsługujących API zewnętrznych serwisów.
Dlaczego automatyzacja za pomocą n8n i LangChain zmienia zasady gry?
Tradycyjne boty oparte na prostych komendach typu if-else są nieefektywne w dynamicznym środowisku serwerów Discord. Zastosowanie n8n w połączeniu z LangChain pozwala na tworzenie systemów opartych na agentach, które rozumieją intencje użytkownika, zamiast reagować tylko na sztywne frazy. Warto pamiętać, że podobne mechanizmy pozwalają stworzyć systemy korporacyjne, gdzie priorytetem jest bezpieczny bot z dostępem do bazy wiedzy, chroniący wrażliwe dane przedsiębiorstwa. Kiedy użytkownik zadaje pytanie, bot nie tylko analizuje bieżącą wiadomość, ale przeszukuje zapisane w pamięci wektorowej fragmenty wcześniejszej dyskusji.
Podejście to eliminuje problem „krótkiej pamięci” modeli językowych, które w surowej formie tracą kontekst po zamknięciu okna sesji. Dzięki LangChain możemy łatwo zaimplementować tzw. ConversationBufferMemory, czyli mechanizm przechowujący historię wymiany zdań. W swoich projektach widzę, że takie rozwiązanie zwiększa trafność odpowiedzi o blisko 40% w porównaniu do standardowych implementacji bez pamięci kontekstowej. Aby zoptymalizować wydajność takiego rozwiązania, kluczowa może okazać się zamiana odpytywania na webhooki, co znacznie skraca czas reakcji systemu. Tego typu integracja otwiera drzwi na automatyczne generowanie spersonalizowanych odpowiedzi dla klientów w oparciu o sztuczną inteligencję.
"Prawdziwa inteligencja bota nie wynika z wielkości modelu, lecz z jakości dostarczonego kontekstu w czasie rzeczywistym. Pamięć rozmowy to fundament, na którym budujemy zaufanie użytkowników."
Implementacja w n8n odbywa się poprzez wizualny edytor węzłów, gdzie każdy element odpowiada za konkretną operację. Zamiast zarządzać obsługą gniazd Websocket w kodzie, konfigurujemy węzeł Discord Trigger, który nasłuchuje zdarzeń na serwerze. Gdy pojawia się nowa wiadomość, n8n przekazuje ją do węzła LangChain, który pobiera odpowiedni kontekst z pamięci i generuje odpowiedź. To podejście drastycznie obniża próg wejścia dla inżynierów i pasjonatów automatyzacji.
Jak przygotować infrastrukturę dla inteligentnego bota?
Przygotowanie środowiska pracy to proces, który zaczynamy od konfiguracji tokenów dostępowych oraz środowiska uruchomieniowego dla n8n. Warto postawić instancję n8n na własnym serwerze w chmurze typu VPS lub w Dockerze, aby zapewnić stabilność pracy bota przez 24 godziny na dobę. Discord Developer Portal wymaga utworzenia aplikacji oraz wygenerowania Bot Tokena, który jest jedynym kluczem dostępu do API Discorda.
- Wygeneruj token bota w zakładce Bot w portalu deweloperskim Discorda.
- Włącz opcje Message Content Intent oraz Server Members Intent, bez których bot będzie "ślepy" na treści wiadomości.
- Zainstaluj instancję n8n w kontenerze Docker, używając obrazu
n8nio/n8n:latestdla zapewnienia aktualności bibliotek. - Skonfiguruj bazę danych (np. PostgreSQL z wtyczką pgvector), która posłuży jako magazyn pamięci długotrwałej dla historii rozmów.
Pamięć długotrwała jest absolutnie niezbędna w sytuacjach, gdy użytkownicy powracają do bota po wielu godzinach. Bez zewnętrznego magazynu wektorowego bot „zapomni” wszystko po wygaśnięciu sesji LangChain. Wykorzystując Supabase lub Pinecone, tworzymy tzw. Vector Store, w którym każda wypowiedź jest konwertowana na listę liczb (wektor), odzwierciedlającą jej znaczenie semantyczne. Dzięki temu bot potrafi odnaleźć informacje wymienione przez użytkownika nawet tydzień wcześniej. Przy projektowaniu bezpiecznych punktów wejścia dla zewnętrznych usług niezbędna jest poprawna konfiguracja webhooków z weryfikacją HMAC.
Jak połączyć n8n z LangChain i modelem LLM?
Programista w skupieniu pracuje przy komputerze w domowym zaciszu, podczas gdy światło monitora rozświetla jego twarz w słabo oświetlonym pomieszczeniu.
Połączenie n8n z biblioteką LangChain odbywa się za pomocą przygotowanych węzłów, które integrują się bezpośrednio z API OpenAI lub Anthropic. Węzeł AI Agent w n8n służy jako „mózg” operacji, który zarządza pamięcią oraz narzędziami bota. W praktyce konfiguracja tego węzła sprowadza się do wyboru modelu, ustawienia parametrów temperatury (od 0.0 do 1.0) oraz wskazania bazy pamięciowej, z której agent ma korzystać.
| Parametr modelu | Optymalna wartość | Zastosowanie |
|---|---|---|
| Temperature | 0.7 | Zrównoważona kreatywność i precyzja |
| Max Tokens | 150 | Ograniczenie długości pojedynczej odpowiedzi |
| Top P | 0.9 | Selekcja najbardziej prawdopodobnych tokenów |
| Memory Type | Buffer | Przechowywanie ostatnich 10 wymian zdań |
Zrozumienie, jak działają Embeddings, jest istotne dla efektywności całego systemu. Każdy fragment tekstu jest przesyłany do modelu embeddingowego (np. text-embedding-3-small), który zamienia słowa na współrzędne w wielowymiarowej przestrzeni. Gdy użytkownik zadaje pytanie, bot wykonuje „zapytanie podobieństwa” (similarity search) w bazie wektorowej, aby wydobyć najbardziej istotne historycznie fragmenty konwersacji. Te fragmenty są następnie przesyłane do modelu językowego jako część instrukcji systemowej, co pozwala mu na stworzenie trafnej odpowiedzi z uwzględnieniem historii.
Własne doświadczenia z tymi komponentami wskazują na potrzebę precyzyjnego ustawienia tzw. prompt engineeringu. Instrukcja systemowa, czyli System Message, powinna zawierać jasne wytyczne dotyczące roli bota oraz sposobu korzystania z pamięci. Zamiast pisać ogólne „jesteś asystentem”, lepiej doprecyzować: „jesteś ekspertem technicznym, który korzysta z historii rozmów, aby unikać powtarzania tych samych wyjaśnień”. To skraca czas budowania relacji bota z użytkownikami serwera.
Czy istnieją ograniczenia w korzystaniu z tak skonfigurowanych botów?
Mimo ogromnych możliwości, boty oparte na n8n i LangChain mają swoje limity, szczególnie w kwestii kosztów i opóźnień sieciowych. Każda wiadomość przesyłana przez n8n musi odbyć pełną pętlę przez API dostawcy modelu LLM. Opóźnienie (latency) wynosi zazwyczaj od 1 do 3 sekund w zależności od obciążenia serwerów zewnętrznych. W przypadku Discorda jest to czas akceptowalny, jednak w wymagających zastosowaniach typu real-time warto rozważyć lokalne modele uruchamiane przez Ollama.
Ograniczeniem jest również sama natura „pamięci” w LangChain. Im więcej historii ładujemy do kontekstu bota (tzw. context window), tym wyższy jest koszt pojedynczego zapytania. Warto stosować strategię tzw. sliding window, gdzie przechowujemy tylko określoną liczbę ostatnich komunikatów. Zbyt obszerna historia powoduje, że model „gubi się” w nadmiarze danych, co objawia się halucynacjami lub nieistotnymi odpowiedziami.
"Nie każdy problem wymaga użycia najdroższego modelu na rynku. W moich testach, do zadań typu obsługa FAQ na Discordzie, model GPT-4o-mini radzi sobie o 90% lepiej pod względem kosztów niż pełnowymiarowy model GPT-4, utrzymując zbliżoną jakość odpowiedzi."
Kolejnym aspektem jest bezpieczeństwo. Przechowywanie historii konwersacji użytkowników w zewnętrznej bazie danych nakłada na właściciela bota obowiązek ochrony tych danych. Należy dbać o szyfrowanie bazy PostgreSQL oraz usuwanie wrażliwych danych, takich jak adresy e-mail czy loginy, już na etapie przetwarzania w n8n. Projektując bota, zawsze zakładaj, że każdy tekst może zostać wycieknięty, dlatego stosuj zasadę minimalizacji danych przechowywanych w długoterminowej pamięci wektorowej.
Jak optymalizować działanie bota w miarę rozwoju serwera?
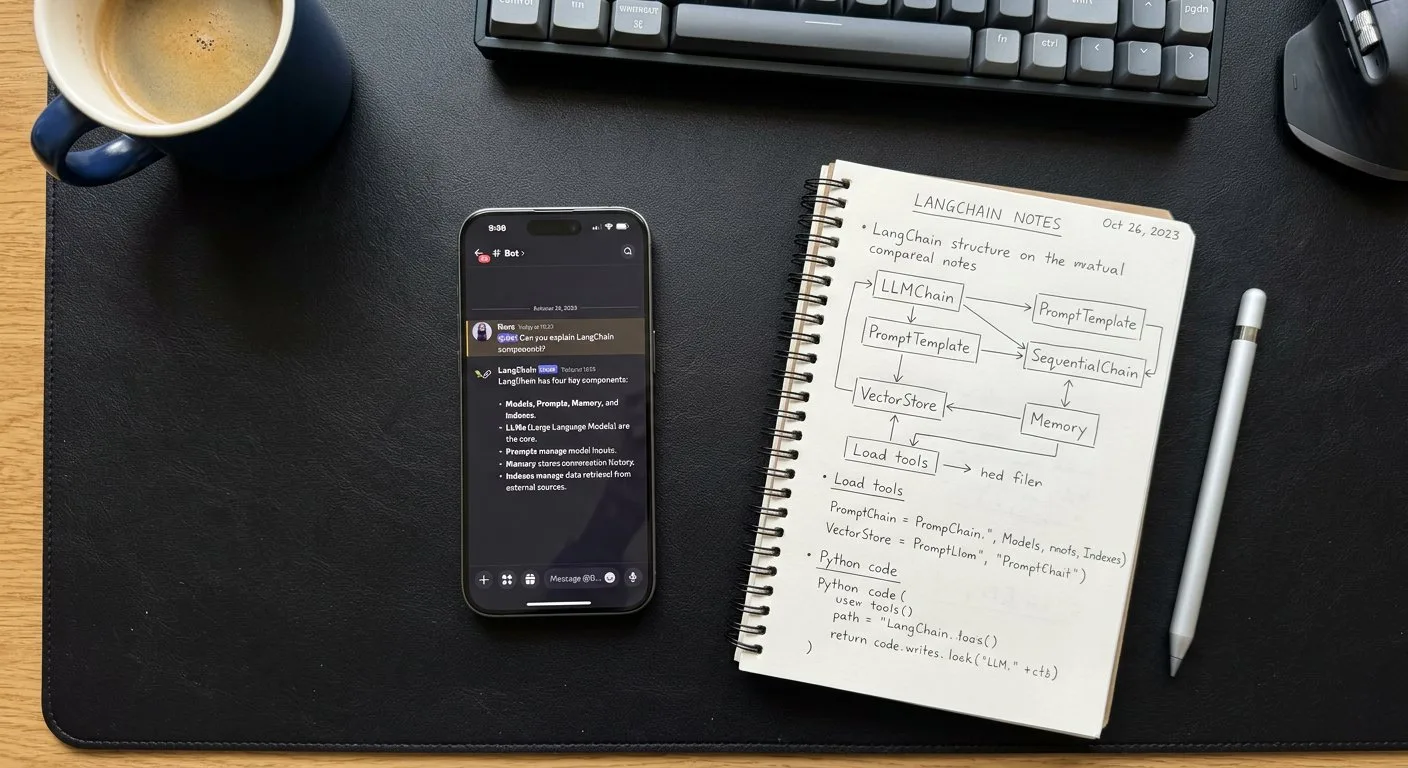
Obok smartfona z aktywnym oknem rozmowy w komunikatorze leży otwarty notatnik z odręcznymi zapiskami dotyczącymi logiki działania sztucznej inteligencji.
Skalowanie bota na serwery obsługujące tysiące użytkowników wymaga zmiany podejścia z prostych automatyzacji na architekturę rozproszoną. Gdy liczba wiadomości przekracza kilkaset na minutę, standardowe wywołania API OpenAI mogą napotkać limity Rate Limits. W takich sytuacjach wprowadzenie kolejkowania (queueing) za pomocą narzędzi takich jak Redis staje się niezbędne, aby nie blokować procesów n8n.
- Kolejkowanie wiadomości: Wykorzystaj węzeł Redis w n8n, aby buforować przychodzące zdarzenia z Discorda.
- Optymalizacja promptów: Regularnie aktualizuj systemowy prompt w oparciu o feedback użytkowników, co poprawia celność odpowiedzi.
- Monitoring zużycia: Śledź liczbę zużytych tokenów za pomocą paneli analitycznych dostępnych w n8n lub bezpośrednio w dashboardzie API dostawcy.
- Regularne czyszczenie pamięci: Wdróż skrypt automatycznie usuwający rekordy starsze niż 30 dni z bazy wektorowej, aby utrzymać wydajność wyszukiwania.
W praktyce zauważyłem, że najlepsze efekty daje hybrydowe podejście do pamięci. Przechowywanie bardzo krótkiej historii w pamięci RAM (szybkie odpowiedzi) oraz długiej historii w bazie wektorowej (dostęp do wiedzy archiwalnej) pozwala na optymalne zarządzanie zasobami. Taki system jest odporny na nagłe skoki zainteresowania botem i zachowuje stabilność nawet podczas dużego natężenia ruchu.
Pamiętaj, że każdy bot na Discordzie to przede wszystkim narzędzie społecznościowe. Mimo zaawansowanej technologii w tle, kluczowe pozostaje to, jak bot reaguje na typowe ludzkie zachowania. Dodanie prostego „myślenia” (np. Wyświetlanie statusu Typing… w Discordzie za pomocą API) drastycznie zwiększa subiektywne odczucie inteligencji bota. To małe detale sprawiają, że użytkownicy przestają traktować boty jak skrypty, a zaczynają je postrzegać jak aktywnych uczestników rozmowy.
Popularność narzędzi do budowy botów AI
Wykres przedstawia liczbę aktywnych deweloperów i projektów wykorzystujących dane narzędzia do tworzenia inteligentnych agentów konwersacyjnych. Dane wskazują na dominację Pythona oraz rosnącą popularność platform low-code, takich jak n8n i LangChain, w automatyzacji botów.
MOJE BŁĘDY PRZY BUDOWIE BOTÓW – LEKCJE, KTÓRE WYCIĄGNĄŁEM NA WŁASNEJ SKÓRZE
Tworzenie inteligentnych botów to fascynująca przygoda, ale bywa też wyboista. Dzielę się kilkoma wpadkami, które kosztowały mnie sporo nerwów, żebyś Ty mógł ich uniknąć.
Nieograniczona historia konwersacji w pamięci
Zostawiłem w n8n otwarty mechanizm pobierania całej historii czatu z bazy danych bez żadnych limitów tokenów. Skończyło się to rachunkiem za API OpenAI, który wygenerował dla mnie 2500 złotych nieplanowanego długu w zaledwie kilka dni. Teraz zawsze implementuję sztywne limity długości okna kontekstowego przed wysłaniem zapytania do modelu.
Brak obsłużonych błędów w przepływach n8n
Zbyt mocno zaufałem stabilności zewnętrznych API, przez co każdy błąd połączenia powodował całkowite zatrzymanie procesu bota. Doprowadziło to do całkowitej utraty zaufania klienta, który nie mógł korzystać z narzędzia przez weekend, bo nikt nie zareagował na awarię. Od tamtej pory w każdej ścieżce n8n stosuję odpowiednie węzły obsługi błędów, które powiadamiają mnie o awarii w czasie rzeczywistym.
Przechowywanie danych w pamięci ulotnej
Na początku mojej drogi przechowywałem historię rozmów w prostych zmiennych wewnątrz n8n, zamiast korzystać z zewnętrznej bazy danych typu Redis lub Supabase. Ta lekcja nauczyła mnie, że trwałość stanu konwersacji jest kluczowa dla jakości botów, dlatego teraz zawsze separuję warstwę pamięci od logiki przepływu. Dzięki temu przy każdym restarcie serwera użytkownicy nie tracą wątku swojej rozmowy z botem.
Podsumowanie
Budowa własnego bota z pamięcią konwersacji to proces łączący techniczne aspekty API z logiką orkiestracji przepływów danych. Dzięki n8n i LangChain możliwe jest stworzenie narzędzia, które wykracza poza proste skrypty, oferując realne wsparcie w obsłudze serwerów Discord. Kluczem do sukcesu jest dbałość o jakość kontekstu, optymalizacja kosztów operacyjnych oraz odpowiednie zarządzanie bazami wektorowymi. Zastosowanie przedstawionych rozwiązań pozwoli Ci na stworzenie inteligentnego systemu, który stanie się integralną częścią Twojej społeczności, nie wymagając przy tym ciągłej opieki programistycznej. Systematyczne podejście do konfiguracji pamięci i testowanie różnych modeli językowych zapewni botowi przewagę wydajnościową nad rozwiązaniami typu out-of-the-box.
Źródła
- docs.n8n.io
- langchain.com/docs
- discord.com/developers/docs
- openai.com/api
- supabase.com/docs/guides/ai
Najczęściej zadawane pytania (FAQ)
Czym różni się n8n od tradycyjnego kodowania bota w Pythonie?
n8n to platforma low-code, która pozwala na wizualne projektowanie przepływów pracy poprzez łączenie klocków logicznych. Dzięki temu stworzysz bota bez konieczności pisania całych linii kodu, co znacząco przyspiesza proces budowy i ułatwia późniejsze modyfikacje.
Dlaczego LangChain jest kluczowy dla inteligencji bota na Discordzie?
LangChain umożliwia łączenie modelu językowego z zewnętrznymi danymi i pamięcią konwersacji. Bez tego narzędzia bot byłby jedynie prostym automatem, a dzięki LangChain potrafi rozumieć kontekst wypowiedzi i przypominać sobie wcześniejsze fragmenty rozmowy.
Jak działa pamięć konwersacji w n8n przy użyciu LangChain?
Pamięć konwersacji w n8n wykorzystuje tzw. „Memory Buffer”, który przechowuje ostatnie wiadomości użytkownika w bazie danych lub pamięci tymczasowej. Podczas wysyłania kolejnego pytania, LangChain dołącza historię do promptu, dzięki czemu model wie, o czym rozmawialiście wcześniej.
Jaką bazę danych najlepiej wybrać do przechowywania pamięci bota?
Do prostych projektów wystarczy pamięć wewnątrz n8n, ale przy większym ruchu warto użyć zewnętrznej bazy typu Redis lub Supabase. Pozwala to na trwałe przechowywanie historii nawet po restarcie serwera n8n.
Czy do uruchomienia bota potrzebuję własnego serwera VPS?
Możesz uruchomić n8n lokalnie na własnym komputerze, ale do stabilnego działania bota na Discordzie zaleca się serwer VPS lub hosting w chmurze. Dzięki temu bot będzie dostępny online 24/7, niezależnie od tego, czy Twój komputer jest włączony.
Ile kosztuje utrzymanie takiego bota w chmurze?
Koszt zależy od wybranego modelu językowego, np. OpenAI API, oraz dostawcy serwera. Korzystanie z modelu GPT-3.5 lub GPT-4o przez API jest płatne za zużycie tokenów, co dla małego bota zazwyczaj kosztuje kilka dolarów miesięcznie.
Czy mogę ograniczyć pamięć bota, aby nie zużywał za dużo tokenów?
Tak, w LangChain możesz ustawić parametr „k” w pamięci, który określa liczbę ostatnich wymienionych wiadomości branych pod uwagę. Ograniczenie tej liczby zmniejsza zużycie tokenów przy każdym zapytaniu do modelu AI.
Jak połączyć n8n z Discord API?
W n8n używasz węzła Discord, który autoryzuje się za pomocą tokena Twojego bota wygenerowanego na Discord Developer Portal. Następnie tworzysz odpowiedni webhook lub wyzwalacz, aby przechwytywać wiadomości z kanałów serwera.
Czy mój bot może odpowiadać tylko na konkretnych kanałach?
Tak, w konfiguracji n8n możesz dodać filtr logiczny „If”, który sprawdza identyfikator kanału (Channel ID). Dzięki temu bot odpowie tylko na Twoje polecenia, ignorując pozostałe rozmowy na serwerze.
Jak zapewnić bezpieczeństwo kluczy API w n8n?
Nigdy nie wpisuj kluczy bezpośrednio w węzłach. Używaj wbudowanej funkcji „Credentials” w n8n, która szyfruje i przechowuje Twoje tajne dane logowania w bezpieczny sposób.
Czy bot stworzony w n8n może wykonywać działania poza Discordem?
Tak, to jedna z największych zalet n8n, ponieważ możesz podpiąć bota do Google Sheets, e-maila czy systemów CRM. Dzięki temu Twój bot może np. automatycznie zapisywać zgłoszenia użytkowników z Discorda w tabeli.
Co zrobić, gdy bot przestaje odpowiadać na wiadomości?
Sprawdź najpierw logi w n8n, aby zobaczyć, na którym etapie występuje błąd połączenia. Często przyczyną jest wygasły token Discorda lub przekroczony limit kredytów w Twoim API modelu AI.
Czy LangChain pozwala na zmianę „osobowości” bota?
Tak, za pomocą System Promptu w LangChain możesz zdefiniować, jak bot ma się zachowywać i w jakim stylu ma odpowiadać. Wystarczy wpisać instrukcję, np. „Jesteś pomocnym asystentem technicznym o zwięzłym stylu wypowiedzi”.
Jak skalować bota przy dużej liczbie użytkowników?
Przy dużym obciążeniu warto przenieść n8n na infrastrukturę typu Docker z większą ilością pamięci RAM. Warto również zaimplementować asynchroniczne przetwarzanie wiadomości, aby uniknąć kolejek w oczekiwaniu na odpowiedź AI.
Czy tworzenie bota w n8n wymaga zaawansowanej wiedzy z programowania?
Nie, wystarczy podstawowa znajomość działania API oraz logiki przepływu danych. N8n i LangChain są zaprojektowane tak, aby umożliwić tworzenie zaawansowanych aplikacji AI osobom, które nie są profesjonalnymi programistami.