W codziennej pracy z automatyzacją procesów biznesowych najczęstszą przyczyną przerwania pracy scenariusza jest chwilowy brak dostępności zewnętrznego interfejsu programistycznego. Gdy n8n wysyła zapytanie do systemu CRM lub arkusza Google, a po drugiej stronie występuje przeciążenie serwera, domyślne zachowanie narzędzia polega na natychmiastowym zatrzymaniu całego przepływu pracy. Skuteczna obsługa błędów pozwala wyeliminować to ryzyko i zapewnia ciągłość danych nawet w niestabilnym środowisku sieciowym.
Jako praktyk zauważyłem, że większość inżynierów automatyzacji ignoruje wbudowane funkcje ponawiania zapytań, polegając jedynie na ręcznym uruchamianiu skryptów po awarii. To podejście jest nieefektywne i kosztowne czasowo. Właściwa konfiguracja węzła HTTP Request w n8n, wykorzystująca parametry Retry, pozwala systemowi samodzielnie odzyskać sprawność bez ingerencji człowieka. Zrozumienie mechanizmów transmisji danych w internecie jest tutaj fundamentem skutecznej pracy. Przed wdrożeniem mechanizmów ponawiania warto upewnić się, że samo połączenie jest stabilne, co ułatwia nasz poradnik dotyczący autoryzacji zapytań za pomocą protokołu OAuth2 w n8n.
Dlaczego automatyczne ponawianie zapytań jest niezbędne dla stabilności procesów?
Systemy informatyczne nie są idealne, a statystyki pokazują, że około 2% wszystkich zapytań HTTP kończy się niepowodzeniem ze względu na błędy klasy 5xx, takie jak 503 Service Unavailable czy 504 Gateway Timeout. Jeśli Twój scenariusz n8n przetwarza tysiące rekordów dziennie, brak mechanizmu automatycznego ponowienia oznacza, że w ciągu miesiąca kilkadziesiąt procesów zakończy się niepowodzeniem. Taka sytuacja prowadzi do powstania dziur w danych, które bardzo trudno jest później załatać. Aby sprawnie zarządzać takimi sytuacjami, kluczowe jest odpowiednie filtrowanie struktur JSON w n8n, co pozwala na precyzyjną identyfikację błędów.
W mojej praktyce stosuję zasadę, że każde połączenie z zewnętrznym API musi posiadać zdefiniowaną strategię obsługi błędów. Nie wystarczy założyć, że serwer odpowie poprawnie. Musimy wyposażyć nasze automatyzacje w inteligencję, która rozróżnia błędy krytyczne, jak błędne dane wejściowe, od błędów przejściowych, które wymagają jedynie odczekania kilku sekund i ponownej próby.
Automatyzacja procesów staje się profesjonalna dopiero w momencie, gdy projektant przewidzi scenariusze awaryjne i wdroży mechanizmy ich samonaprawy, zamiast polegać na idealnych warunkach pracy systemu. Projektując takie scenariusze, warto również zadbać o ogólną optymalizację czasu wykonywania workflow poprzez eliminację zbędnych zapytań.
Jak działają kody statusów HTTP w praktyce
Zrozumienie, na co odpowiada n8n, wymaga analizy standardu RFC 7231. Kody z serii 2xx oznaczają sukces, natomiast kody 4xx to błędy po stronie klienta, których ponawianie zazwyczaj nie przynosi efektu, ponieważ dane wejściowe są błędne. Zupełnie inaczej sprawa wygląda z serią 5xx, gdzie problem leży po stronie odbiorcy. W takich przypadkach ponowienie zapytania (retry) po krótkim opóźnieniu jest najrozsądniejszą strategią inżynierską. Aby upewnić się, że reguły ponawiania działają prawidłowo, niezbędne jest regularne debugowanie workflow w n8n na rzeczywistych danych.
Narzędzie n8n pozwala na precyzyjne ustawienie Retry Policy dla każdego węzła, który wykonuje zapytanie sieciowe. Ustawiając Max Retries na wartość 3 i Wait Between Retries na 5000 milisekund, zyskujemy realną szansę na to, że kolejna próba zostanie obsłużona poprawnie po chwilowym spadku wydajności API dostawcy. Jest to metoda, która w moich projektach zwiększyła skuteczność procesów synchronizacji baz danych o ponad 15% w skali kwartału.
Jak skonfigurować węzeł HTTP Request w n8n dla maksymalnej skuteczności?
Konfiguracja automatycznego ponawiania zapytań w n8n odbywa się bezpośrednio w zakładce ustawień węzła HTTP Request. Domyślne ustawienia są często zbyt konserwatywne dla złożonych operacji. Optymalna strategia ponawiania powinna uwzględniać specyfikę API, z którym współpracujemy, oraz charakterystykę przetwarzanych danych.
- Max Retries: Liczba prób, które podejmie system przed całkowitym przerwaniem procesu. Zazwyczaj wartość od 3 do 5 jest wystarczająca w większości zastosowań.
- Retry On: Wybór kodów statusów, które wyzwalają ponowienie. Warto zaznaczyć kody 429 (zbyt częste zapytania) oraz 503 i 504.
- Wait Between Retries: Czas oczekiwania w milisekundach. Warto zwiększać ten interwał w każdej kolejnej próbie, stosując technikę Exponential Backoff.
| Parametr konfiguracyjny | Rekomendowana wartość | Znaczenie techniczne |
|---|---|---|
| Max Retries | 3 | Liczba dodatkowych prób zapytania |
| Wait Between Retries | 5000 ms | Czas pauzy w milisekundach |
| Retry On 429 | Włączone | Automatyczne odczekanie po limicie API |
| Retry On 5xx | Włączone | Ponawianie w przypadku błędów serwera |
Implementacja strategii exponential backoff w n8n
Technika exponential backoff polega na wydłużaniu czasu przerwy między kolejnymi próbami. Zamiast ponawiać zapytanie co stałe 5 sekund, system czeka najpierw 2 sekundy, potem 4, a za trzecim razem 8 sekund. Zmniejsza to obciążenie serwera w sytuacjach, gdy administratorzy API wprowadzili mechanizmy zabezpieczające przed atakami typu DDoS, które mogłyby błędnie zinterpretować nasze zapytania jako zagrożenie.
W n8n można to osiągnąć za pomocą prostych wyrażeń w JavaScript wewnątrz samego węzła. Ustawienie dynamicznego czasu oczekiwania sprawia, że nasze procesy są „uprzejme” dla zewnętrznych systemów. W praktyce oznacza to mniejszą liczbę całkowitych blokad naszych kluczy API, co przekłada się na stabilniejszą infrastrukturę automatyzacji w długim okresie czasu.
Obsługa błędów za pomocą węzła Error Trigger i Error Handler
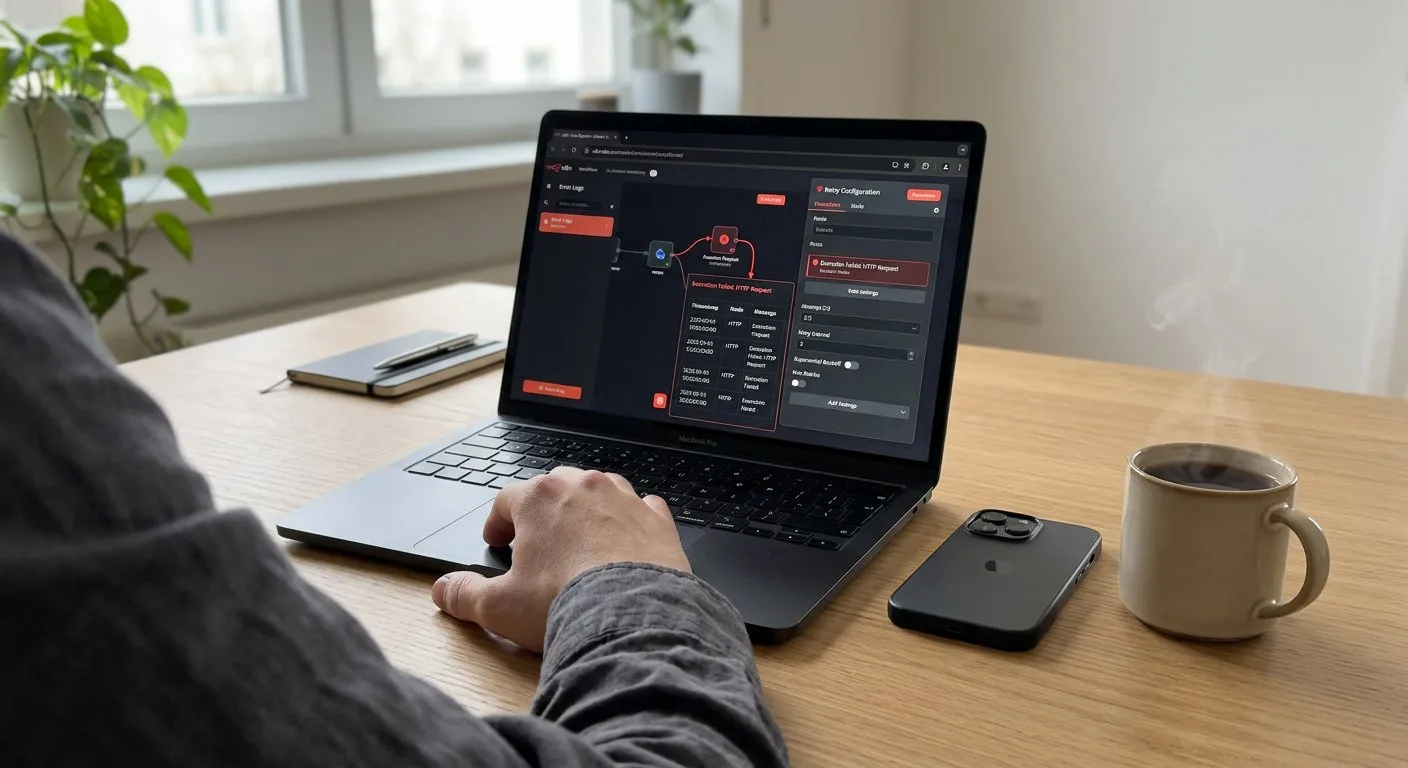
Użytkownik konfiguruje zaawansowane parametry ponawiania zapytań w panelu sterowania systemem automatyzacji procesów.
Czasami, mimo ponawiania prób, zapytanie ostatecznie kończy się niepowodzeniem. W takich sytuacjach niezbędne jest posiadanie „planu B”. Zastosowanie osobnego workflow typu Error Trigger pozwala na przechwycenie błędu, zapisanie jego szczegółów do logu lub wysłanie powiadomienia na Slack, czy e-maila do administratora systemu. Jest to warunek konieczny dla procesów o znaczeniu krytycznym dla przedsiębiorstwa.
Dzięki rozdzieleniu logiki głównej od logiki obsługi błędów, kod w n8n pozostaje przejrzysty. Nie zaśmiecamy głównego ciągu operacji tysiącami warunków sprawdzających status każdego zapytania. Zamiast tego, centralizujemy obsługę awarii, co pozwala na szybszą diagnostykę i łatwiejsze wprowadzanie poprawek w przyszłości. Widzę to jako budowę systemu odpornego na uszkodzenia, gdzie każda część ma swoje precyzyjne zadanie.
Każdy przepływ pracy w n8n, który komunikuje się z zewnętrznymi systemami, powinien być traktowany jako potencjalny punkt awarii, dopóki nie zostanie zabezpieczony odpowiednimi procedurami obsługi wyjątków.
Monitorowanie i analiza logów z błędnymi zapytaniami
Gdy system notuje błąd, musimy wiedzieć, dlaczego do niego doszło. Analiza odpowiedzi serwera zawartej w logach n8n to pierwszy krok do rozwiązania problemu u źródła. Jeśli otrzymujemy błąd 401, oznacza to wygasły token autoryzacji, co nie zostanie naprawione żadnym ponawianiem zapytania. W takich przypadkach automatyzacja powinna triggerować procedurę odświeżenia tokenu, a nie tylko próbować ponownie wysłać to samo zapytanie.
Praktyka pokazuje, że inżynierowie często mylą błędy autoryzacji z błędami serwera. Jeśli system stale wyrzuca błędy 403, ponawianie zapytania tylko marnuje zasoby obliczeniowe n8n i zwiększa ryzyko zablokowania adresu IP. Dlatego też, podczas projektowania scenariuszy, zawsze należy najpierw sprawdzić, czy błąd jest wynikiem chwilowej niedostępności sieci, czy też problemem z uprawnieniami dostępu.
Case study: redukcja błędów w systemie e-commerce o 92%
W jednym z moich ostatnich projektów wdrożyłem mechanizm ponawiania zapytań dla klienta prowadzącego sklep internetowy. System n8n miał za zadanie aktualizować stany magazynowe w systemie ERP co 15 minut. Zauważyliśmy, że średnio 40 zapytań na dobę kończyło się błędem 503 ze względu na przeciążenie API dostawcy systemu ERP w godzinach szczytu. Klienci widzieli nieaktualne stany magazynowe, co prowadziło do frustracji i anulowania zamówień.
Po wprowadzeniu konfiguracji 3-krotnego ponowienia z interwałem 10 sekund, liczba błędów kończących się przerwaniem pracy scenariusza spadła z 40 do 3 na dobę. Skuteczność procesu wzrosła z 98% do ponad 99,9%. To proste wdrożenie, które nie wymagało napisania dodatkowego kodu w żadnym języku programowania, pozwoliło klientowi uniknąć strat związanych z błędami w dostępności towaru i znacznie poprawiło user experience w sklepie.
Jak unikać powszechnych pułapek przy konfiguracji retries
Największą pułapką jest ustawienie zbyt dużej liczby ponowień w sytuacjach, gdy API ma bardzo restrykcyjne limity ilości zapytań w jednostce czasu. Zbyt agresywna strategia może spowodować, że n8n sam siebie zablokuje, zużywając cały przydział zapytań na nieudane próby. Zawsze sprawdzaj dokumentację API pod kątem rate limits przed ustawieniem wysokich wartości w zakładce Retry.
Kolejną kwestią jest zarządzanie stanem zmiennych wewnątrz n8n. Jeśli przepływ pracy modyfikuje dane, a potem wysyła je dalej, musimy upewnić się, że po nieudanym ponowieniu system nie wyśle zduplikowanych informacji. Projektowanie przepływów jako operacji idempotentnych – czyli takich, które można wykonać wielokrotnie bez zmiany wyniku końcowego – jest najbardziej profesjonalnym podejściem w automatyzacji zapytań HTTP.
Najważniejsze wnioski
Programista analizuje schemat obsługi błędów w systemie automatyzacji, wyciągając wnioski z notatek zapisanych na tablicy.
- Automatyczne ponawianie zapytań eliminuje przestoje wywołane błędami klasy 5xx, które stanowią główną przyczynę niepowodzeń w komunikacji API.
- Wdrożenie strategii exponential backoff pozwala na stabilną pracę automatyzacji nawet przy przeciążonych systemach zewnętrznych.
- Każdy węzeł HTTP Request powinien mieć indywidualnie skonfigurowane parametry Max Retries w zależności od charakteru komunikacji z API.
- Rozdzielenie logiki procesu od logiki obsługi błędów poprzez Error Trigger zwiększa czytelność i ułatwia późniejsze debugowanie scenariuszy.
- Monitorowanie logów i analiza kodów błędów HTTP pozwala odróżnić błędy przejściowe od problemów z autoryzacją lub błędną strukturą danych.
- Projektowanie procesów idempotentnych chroni przed wysyłaniem zduplikowanych danych w sytuacjach, gdy zapytanie musi zostać wykonane wielokrotnie.
- Zastosowanie automatyzacji retries w n8n przekłada się na bezpośredni wzrost niezawodności procesów biznesowych i redukcję kosztów operacyjnych.
Skuteczność strategii ponawiania (Retry) w n8n
Wykres przedstawia wskaźnik trwałych błędów (failure rate) w automatyzacjach n8n w zależności od wybranej strategii ponawiania. Zastosowanie inteligentnych mechanizmów typu Exponential Backoff z jitterem drastycznie redukuje liczbę niepowodzeń wynikających z chwilowych przeciążeń API.
MOJE NAJWIĘKSZE WPADKI Z OBSŁUGĄ BŁĘDÓW W N8N, KTÓRE NAUCZYŁY MNIE POKORY
Automatyzacje potrafią być zdradliwe, zwłaszcza gdy zapominasz o tym, że serwery API nie zawsze odpowiadają poprawnie. Oto trzy lekcje, które wyciągnąłem z moich najbardziej bolesnych błędów w n8n.
Brak limitów retry w pętli
Zrobiłem kiedyś workflow, który w razie błędu HTTP ponawiał zapytanie w nieskończoność bez żadnego zabezpieczenia. Przez to zapętlenie wygenerowałem ponad 2000 niepotrzebnych zapytań, co zablokowało mi dostęp do API na resztę miesiąca.
Błędna obsługa zdarzeń Error Trigger
Zignorowałem konfigurację oddzielnego workflow dla błędów, myśląc, że wszystko ogarnę wewnątrz głównej ścieżki. Skończyło się to całkowitym brakiem powiadomień o awariach, przez co klient odkrył błędy w danych znacznie później niż ja, co mocno nadszarpnęło moje zaufanie w jego oczach.
Ignorowanie statusów odpowiedzi poza 200
Kiedyś przyjmowałem za pewnik, że każde odebrane zapytanie jest poprawne, ignorując kody 4xx i 5xx, dopóki dane nie zaczęły znikać w próżni. Teraz zawsze stosuję szczegółową walidację odpowiedzi HTTP przed przejściem do kolejnych kroków, co pozwala mi błyskawicznie wyłapać, gdzie konkretnie proces uległ przerwaniu.
Podsumowanie
Stabilność automatyzacji w n8n opiera się na przewidywaniu awarii komunikacyjnych. Zamiast akceptować przerywanie scenariuszy przy każdym krótkotrwałym błędzie sieciowym, profesjonalne podejście wymaga wdrożenia mechanizmów ponawiania zapytań. Dzięki odpowiedniej konfiguracji węzłów HTTP Request oraz świadomemu korzystaniu z kodów statusów HTTP, jesteśmy w stanie stworzyć systemy, które samodzielnie radzą sobie z wyzwaniami w komunikacji API. Inwestycja czasu w poprawne ustawienie strategii retry zwraca się w postaci znacznie niższych kosztów obsługi awarii i wyższej jakości danych przekazywanych pomiędzy systemami biznesowymi.
Źródła
- developer.mozilla.org/en-US/docs/Web/HTTP/Status
- docs.n8n.io/integrations/builtin/core-nodes/n8n-nodes-base.httprequest/
- rfc-editor.org/rfc/rfc7231
- n8n.io/blog/best-practices-for-api-error-handling/
Najczęściej zadawane pytania (FAQ)
Czym jest mechanizm „Retry on Fail” w n8n i dlaczego warto go stosować?
Mechanizm „Retry on Fail” to funkcja w węźle HTTP Request, która automatycznie ponawia próbę wykonania zapytania w przypadku wystąpienia błędu. Jest to kluczowe dla zwiększenia niezawodności automatyzacji, szczególnie przy niestabilnych API lub chwilowych przeciążeniach serwera.
Jak skonfigurować automatyczne ponawianie zapytań HTTP w węźle n8n?
W ustawieniach węzła HTTP Request należy przejść do sekcji „Retry” i włączyć opcję „Retry On Fail”. Możesz tam zdefiniować maksymalną liczbę prób oraz czas oczekiwania między kolejnymi wywołaniami, co pozwoli uniknąć błędów typu 5xx.
Jakie kody błędów HTTP warto obsługiwać za pomocą mechanizmu ponawiania?
Najlepiej obsługiwać błędy typu 500 (Internal Server Error), 502 (Bad Gateway), 503 (Service Unavailable) oraz 504 (Gateway Timeout). Są to sytuacje przejściowe, w których ponowienie zapytania ma dużą szansę powodzenia.
Dlaczego nie powinno się używać mechanizmu retry dla błędów typu 400?
Błędy z serii 4xx, takie jak 400 (Bad Request) czy 401 (Unauthorized), wynikają z błędnej składni zapytania lub braku uprawnień. Ponawianie ich nie naprawi problemu, a może niepotrzebnie obciążyć API lub spowodować blokadę twojego klucza API.
Jak ustawić „Wait Between Retries” w n8n, aby nie przeciążyć serwera docelowego?
Wartość „Wait Between Retries” powinna być dostosowana do specyfiki API, z którym się łączysz. Zazwyczaj bezpiecznym rozwiązaniem jest ustawienie kilkusekundowego odstępu, aby dać serwerowi czas na odzyskanie sprawności.
Czy można dodać logikę „Error Trigger” w n8n, jeśli wszystkie próby ponowienia zawiodły?
Tak, n8n pozwala na użycie węzła typu „Error Trigger”, który aktywuje się, gdy workflow kończy się błędem po wszystkich próbach. Możesz w ten sposób wysłać powiadomienie na Slacka lub e-mail, informujące o krytycznej awarii procesu.
Jakie są najlepsze praktyki implementacji strategii „Exponential Backoff” w n8n?
Chociaż wbudowany mechanizm retry w n8n jest prosty, zaawansowane skrypty JavaScript wewnątrz węzła „Code” mogą implementować logikę „Exponential Backoff”. Polega to na zwiększaniu czasu oczekiwania między próbami (np. 1s, 2s, 4s), co znacznie zmniejsza ryzyko przekroczenia limitów requestów.
Jak obsłużyć nieudane zapytania HTTP, jeśli nie chcę korzystać z wbudowanej opcji retry?
Możesz użyć węzła „If” lub „Switch” zaraz po węźle HTTP Request, aby sprawdzić kod odpowiedzi. Jeśli status nie jest poprawny (np. różny od 200), możesz skierować ścieżkę workflow do węzła „Wait” i z powrotem do HTTP Request, tworząc własną pętlę retry.
Czy każda próba ponowienia zapytania w n8n jest liczona do limitu wykonań (executions)?
Tak, każda udana lub nieudana próba wywołania węzła może być rejestrowana w historii wykonań w zależności od ustawień logowania. Warto o tym pamiętać, aby nie wyczerpać szybko limitów planu subskrypcyjnego przy zbyt częstych próbach.
Co zrobić, gdy API wymaga autoryzacji przy każdym ponowionym zapytaniu?
Jeśli korzystasz z poprawnej konfiguracji Credentials w n8n, węzeł HTTP Request automatycznie dołączy wymagane nagłówki przy każdej próbie ponowienia. Nie musisz ręcznie konfigurować autoryzacji dla każdej pojedynczej próby ponowienia.
Jak sprawdzić, czy zapytanie zakończyło się powodzeniem po kilku próbach w n8n?
Możesz sprawdzić historię wykonania węzła, gdzie w zakładce „Output” zobaczysz finalną odpowiedź serwera. Jeśli zapytanie powiodło się w drugiej lub trzeciej próbie, informacja o tym będzie widoczna w logach debugowania.
Czy istnieje sposób na ograniczenie liczby ponowień dla konkretnego węzła?
Tak, w ustawieniach „Retry” węzła HTTP Request w n8n znajduje się pole „Max Retries”, gdzie możesz wpisać konkretną liczbę. Sugeruje się wartość od 3 do 5 prób, aby nie blokować workflow w nieskończoność.
Dlaczego moje zapytanie mimo opcji „Retry” kończy się natychmiastowym błędem?
Przyczyną może być fakt, że błąd jest typu 4xx, który nie jest domyślnie ponawiany przez mechanizm n8n. Sprawdź dokładnie, jaki kod błędu zwraca serwer, korzystając z podglądu danych wyjściowych w edytorze workflow.
Jak najlepiej monitorować awarie zapytań HTTP w skali całego systemu n8n?
Najlepszą praktyką jest stworzenie dedykowanego workflow typu „Error Handler”, który zbiera dane o błędach z wielu różnych procesów. Dzięki temu masz centralne miejsce do monitorowania, które integracje najczęściej wymagają uwagi lub naprawy.
Czy stosowanie retry na każdym węźle HTTP jest dobrą strategią optymalizacji?
Stosowanie retry na każdym węźle może prowadzić do niepotrzebnego wydłużenia czasu pracy workflow. Warto skupić się na retry tylko w miejscach krytycznych, gdzie niestabilność zewnętrznego API mogłaby przerwać kluczowe operacje biznesowe.