Czy zastanawiałeś się kiedyś, ile czasu Twoi pracownicy marnują na przekopywanie się przez setki stron wewnętrznych procedur, regulaminów czy dokumentacji technicznej w poszukiwaniu jednej, prostej odpowiedzi? Według badań McKinsey, przeciętny pracownik biurowy spędza niemal 20% swojego czasu pracy na szukaniu informacji potrzebnych do wykonania zadań. Wyobraź sobie, że ten cały chaos informacyjny znika, a Twoi ludzie zyskują osobistego, genialnego asystenta, który w ułamku sekundy odpowiada na każde pytanie, bazując wyłącznie na zatwierdzonych plikach firmy. Brzmi jak bajka? To rzeczywistość, którą możesz wdrożyć w swojej organizacji już w kilka dni.
Wdrożenie sztucznej inteligencji w biznesie budzi jednak jedno zasadnicze, niezwykle paraliżujące pytanie: co stanie się z poufnymi danymi finansowymi, kadrowymi czy strategicznymi, gdy „nakarmimy” nimi model językowy? Przecież wysłanie raportów finansowych czy danych osobowych klientów do publicznych narzędzi typu ChatGPT to prosty przepis na katastrofę wizerunkową i gigantyczne kary za złamanie RODO. Kluczem do sukcesu jest stworzenie rozwiązania, które łączy potęgę generatywnej sztucznej inteligencji z bezkompromisowym bezpieczeństwem i pełną kontrolą nad przepływem informacji. Warto przy tym pamiętać, że kluczowym aspektem każdego takiego projektu jest również wdrożenie sztucznej inteligencji zgodnie z prawem, co pozwala uniknąć dotkliwych kar finansowych.
Z tego praktycznego przewodnika dowiesz się dokładnie, jak stworzyć bezpiecznego chatbota firmowego z dostępem do wewnętrznej bazy wiedzy, który nie tylko zrewolucjonizuje codzienną pracę Twojego zespołu, ale też zagwarantuje, że żadna poufna informacja nie opuści bezpiecznych serwerów Twojego przedsiębiorstwa. Krok po kroku przejdziemy przez architekturę, dobór technologii, szacowanie kosztów oraz dobre praktyki, które pozwolą Ci uniknąć najczęstszych błędów wdrożeniowych.
Dlaczego tradycyjne wyszukiwarki zawodzą i jak działa RAG
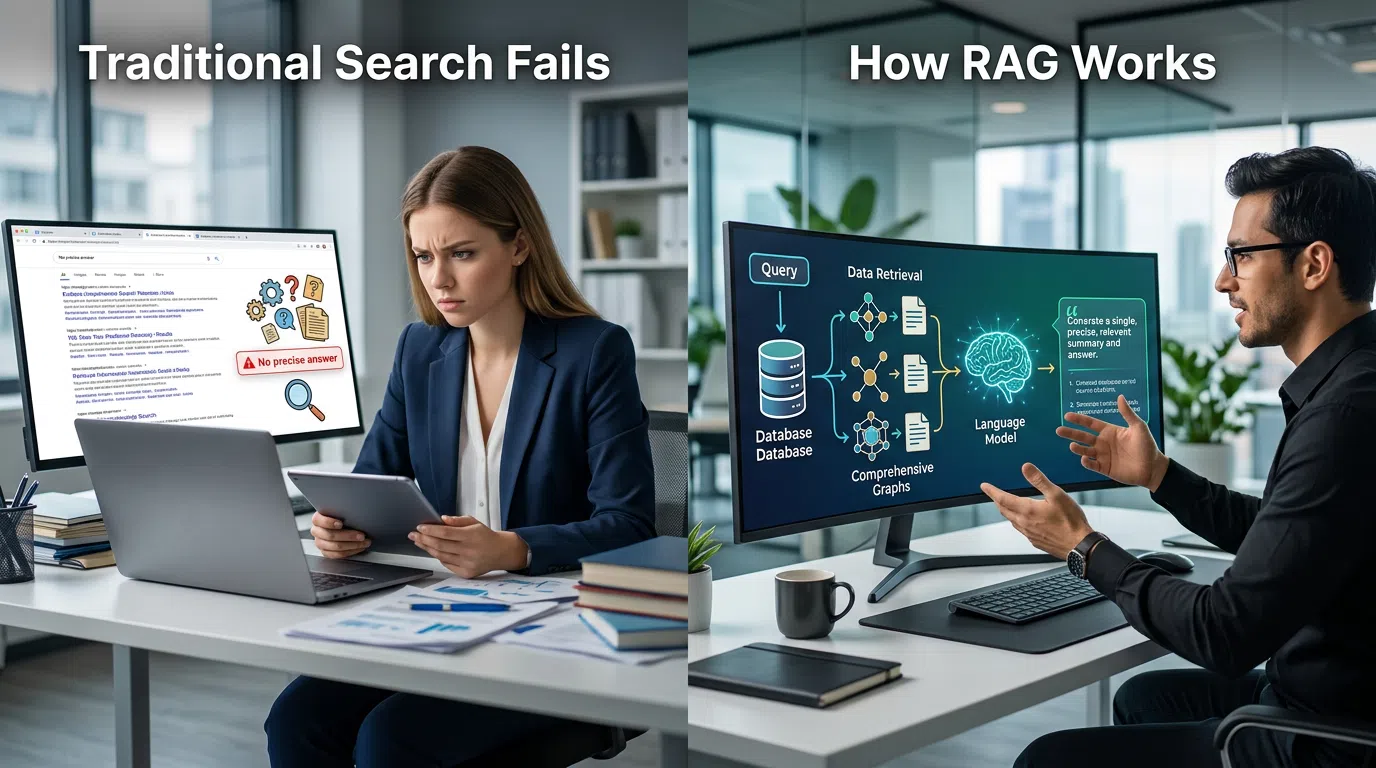
Klasyczne wyszukiwanie wewnątrzfirmowe opiera się na słowach kluczowych. Wpisujesz frazę „procedura urlopowa” i otrzymujesz listę 15 dokumentów PDF, z których każdy ma po 40 stron. Następnie musisz ręcznie otwierać każdy plik i szukać właściwego akapitu. To frustrujące i nieefektywne. Jeśli Twoja baza wiedzy składa się z setek nieuporządkowanych dokumentów, pomocne może okazać się automatyczne parsowanie plików PDF w celu szybkiego wyodrębnienia kluczowych danych. Nowoczesny chatbot firmowy działa zupełnie inaczej, wykorzystując architekturę o nazwie RAG (Retrieval-Augmented Generation), czyli generowanie wspomagane wyszukiwaniem. Dla firm korzystających z zewnętrznych komunikatorów świetnym rozwiązaniem może być również stworzenie bota z pamięcią konwersacji zintegrowanego bezpośrednio z codziennym kanałem komunikacji zespołu.
RAG to pomost łączący ogromną wiedzę ogólną modelu językowego (LLM) z precyzyjnymi, prywatnymi danymi Twojej firmy. Proces ten przebiega w trzech błyskawicznych krokach. Najpierw, gdy zadajesz pytanie, system przeszukuje Twoją bazę wiedzy w poszukiwaniu najbardziej dopasowanych fragmentów dokumentów. Następnie te wyselekcjonowane fragmenty są dołączane do Twojego zapytania jako kontekst. Na koniec model LLM analizuje ten pakiet danych i generuje spójną, naturalną odpowiedź, powołując się wyłącznie na dostarczone źródła. Model nie zmyśla (nie halucynuje), ponieważ ma surowy zakaz wykraczania poza dostarczony kontekst. W wielu przypadkach optymalnym wyborem technologicznym ułatwiającym cały proces jest integracja n8n z API OpenAI, co pozwala na sprawne i elastyczne przesyłanie zapytań.
Największą zaletą tej architektury jest fakt, że nie musisz trenować ani dostrajać (fine-tuning) drogich modeli językowych na własny koszt. Twoje dane nie stają się częścią publicznego modelu. Są one przechowywane w bezpiecznej, wektorowej bazie danych, a model LLM traktuje je jedynie jako jednorazową „ściągawkę” do przygotowania odpowiedzi na konkretne pytanie.
Architektura bezpieczeństwa — gdzie trafiają Twoje dane
Bezpieczeństwo danych to fundament, na którym musi opierać się każdy projekt chatbotowy w biznesie. Decydując się na budowę takiego narzędzia, masz do wyboru dwie główne ścieżki technologiczne: pełne wdrożenie lokalne (On-Premise) lub wykorzystanie bezpiecznych, chmurowych interfejsów API z gwarancją ochrony prywatności (Enterprise Cloud).
Wybór zależy od restrykcji prawnych, branży, w której działasz, oraz budżetu i zasobów IT. Poniższa tabela przedstawia szczegółowe porównanie obu tych podejść pod kątem kluczowych parametrów bezpieczeństwa i wdrożenia.
| Parametr | Model chmurowy Enterprise (np. Azure OpenAI / AWS) | Model lokalny On-Premise (np. Llama 3 / Mistral) |
|---|---|---|
| Lokalizacja danych | Bezpieczna chmura (np. region UE, zgodność z RODO) | Własna infrastruktura serwerowa (100% kontroli) |
| Wykorzystanie danych do treningu | Gwarantowany brak douczania modeli publicznych | Całkowity brak transmisji danych na zewnątrz |
| Koszty początkowe (CAPEX) | Bardzo niskie (płatność za realne zużycie – tokeny) | Wysokie (zakup serwerów z mocnymi kartami GPU) |
| Wymagana wiedza techniczna | Średnia (integracja gotowych API i baz wektorowych) | Bardzo wysoka (utrzymanie infrastruktury, DevOps) |
| Czas wdrożenia (Time-to-market) | Szybki (od kilku dni do kilku tygodni) | Wolny (od kilku tygodni do kilku miesięcy) |
Dla większości średnich firm optymalnym wyborem na start jest skorzystanie z chmury Microsoft Azure OpenAI. Gwarantuje ona, że dane przesyłane przez API są szyfrowane, nie opuszczają wybranego regionu geograficznego (np. Szwajcaria lub Niemcy) i pod żadnym pozorem nie są wykorzystywane do trenowania przyszłych wersji modeli OpenAI. Jeśli jednak reprezentujesz sektor bankowy, medyczny lub rządowy, jedyną drogą może okazać się postawienie lokalnego modelu Llama 3 na własnych serwerach z kartami NVIDIA RTX 4090 lub A100.
Jak krok po kroku zbudować bezpiecznego bota z bazą wiedzy
Budowa systemu nie wymaga pisania kodu od zera. Obecnie rynek oferuje genialne frameworki open-source, które znacząco przyspieszają ten proces. Aby stworzyć sprawnego bota, musisz połączyć ze sobą cztery kluczowe elementy: parser dokumentów, bazę wektorową, silnik orchestracji oraz interfejs użytkownika.
Pierwszym krokiem jest przygotowanie danych. Twoje firmowe pliki PDF, DOCX, prezentacje czy arkusze Excel muszą zostać oczyszczone z niepotrzebnych elementów graficznych i podzielone na mniejsze fragmenty (tzw. chunks) o wielkości np. 1000 znaków. Każdy taki fragment jest następnie przepuszczany przez model embeddingowy, który zamienia tekst na ciąg liczb — wektor reprezentujący semantyczne znaczenie słów. Te wektory zapisujemy w specjalnej bazie danych (np. Pinecone, Qdrant lub PGVector).
Gdy użytkownik wpisuje pytanie, silnik orchestracji (np. LangChain lub Flowise) zamienia to pytanie na wektor, znajduje w bazie danych najbardziej podobne semantycznie fragmenty dokumentów, a następnie wysyła je wraz z pytaniem do bezpiecznego modelu LLM. Model generuje odpowiedź i przekazuje ją do interfejsu, z którego korzysta pracownik.
Zobaczmy to na konkretnym przykładzie, jak taki system radzi sobie z codziennym wyzwaniem w dziale kadr i jak precyzyjnie potrafi odpowiedzieć na skomplikowane zapytanie pracownika.
Scenariusz: Pracownik działu marketingu chce dowiedzieć się, czy przysługuje mu dodatkowy budżet na okulary korekcyjne i jak ma złożyć wniosek.
- Krok 1 (Zapytanie): Pracownik pisze na czacie: „Pracuję przy komputerze 8 godzin dziennie. Czy firma dopłaci mi do nowych okularów i ile mam na to czasu?”.
- Krok 2 (Wyszukiwanie kontekstu): System przeszukuje bazę wektorową zawierającą regulaminy BHP i pracy. Znajduje dwa kluczowe fragmenty: „Dział IV, par. 12: Pracownikom użytkującym monitor ekranowy przez co najmniej 4 godziny dziennie przysługuje dofinansowanie do okularów w kwocie 400 zł raz na 2 lata” oraz „Procedura zakupowa: Fakturę za okulary należy przedłożyć w dziale HR w terminie 30 dni od daty zakupu wraz z wnioskiem zatwierdzonym przez managera”.
- Krok 3 (Generowanie odpowiedzi): Bot łączy te fragmenty i odpowiada: „Tak, przysługuje Ci dofinansowanie w kwocie 400 zł (raz na 2 lata), ponieważ pracujesz przy monitorze powyżej 4 godzin dziennie. Aby otrzymać zwrot, musisz złożyć wniosek zatwierdzony przez managera oraz fakturę w dziale HR w ciągu 30 dni od zakupu. Potrzebne dokumenty znajdziesz w folderze kadrowym na Sharepoincie”.
Dzięki temu procesowi pracownik otrzymał precyzyjną odpowiedź w 3 sekundy, a dział HR nie musiał odpowiadać na to samo pytanie po raz setny w tym miesiącu.
Zarządzanie uprawnieniami — kto może wiedzieć co?
Jednym z największych wyzwań przy wdrażaniu wyszukiwania opartego o RAG w firmie jest kwestia uprawnień do dokumentów. Wyobraź sobie sytuację, w której asystent handlowca pyta bota o zarobki członków zarządu lub plany zwolnień grupowych, a bot bez wahania wyciąga te informacje z poufnych plików działu HR, do których ma dostęp. To niedopuszczalne.
Bezpieczny chatbot musi respektować strukturę uprawnień obowiązującą w Twojej firmie. Rozwiązuje się to poprzez mapowanie uprawnień użytkownika z Active Directory (lub innego systemu IAM) bezpośrednio na metadane w bazie wektorowej. Każdy dokument zapisany w bazie wektorowej posiada etykietę określającą, jakie grupy użytkowników mają do niego dostęp (np. "access_groups": ["HR", "Board"]).
W momencie zadania pytania przez użytkownika, system najpierw weryfikuje jego tożsamość i przynależność do grup. Następnie, podczas przeszukiwania bazy wektorowej, nakłada filtr, który ogranicza wyniki wyszukiwania wyłącznie do dokumentów, do których dany użytkownik ma realne uprawnienia. Jeśli pracownik działu marketingu zapyta o budżet płacowy zarządu, baza wektorowa po prostu nie zwróci tych dokumentów jako kontekstu dla modelu LLM, a bot grzecznie odpowie, że nie posiada takich informacji.
Koszty wdrożenia i utrzymania bezpiecznego chatbota
Ile to wszystko kosztuje? To kluczowe pytanie dla każdego managera i dyrektora finansowego. Koszty wdrożenia chatbota firmowego można podzielić na jednorazowe koszty deweloperskie oraz miesięczne koszty utrzymania infrastruktury i licencji.
Poniższa tabela przedstawia szacunkowy cennik i strukturę kosztów dla średniej wielkości firmy zatrudniającej około 150 pracowników, przy założeniu średniego miesięcznego wolumenu zapytań na poziomie 10 000 interakcji.
| Element kosztowy | Wariant chmurowy (Azure OpenAI) | Wariant lokalny (On-Premise GPU) |
|---|---|---|
| Prace deweloperskie i wdrożenie (jednorazowo) | 15 000 – 35 000 PLN | 25 000 – 55 000 PLN |
| Zakup sprzętu / Serwerów (jednorazowo) | 0 PLN | 18 000 – 30 000 PLN (Serwer z GPU) |
| Miesięczny koszt modelu LLM (API / Prąd) | 150 – 500 PLN (zależnie od zużycia tokenów) | 100 – 250 PLN (koszt energii i chłodzenia) |
| Miesięczny koszt bazy wektorowej | 300 – 800 PLN (np. Pinecone / Qdrant Cloud) | 0 PLN (lokalna instancja pgvector) |
| Utrzymanie i wsparcie techniczne (miesięcznie) | 1 000 – 2 500 PLN | 2 000 – 4 000 PLN |
Jak widać z powyższego zestawienia, wdrożenie oparte na chmurze charakteryzuje się znacznie niższym progiem wejścia i elastycznością kosztową. Płacisz tylko za to, co faktycznie zużyjesz. Wdrożenie lokalne generuje wysoki koszt początkowy związany z zakupem dedykowanego serwera wyposażonego w profesjonalne karty graficzne, ale w dłuższej perspektywie (powyżej 2 lat) przy bardzo intensywnym użytkowaniu może okazać się tańsze w eksploatacji.
Jak przygotować firmowe dokumenty do wdrożenia AI
Istnieje złota zasada w świecie systemów informatycznych: „Garbage in, garbage out” (śmieci na wejściu, śmieci na wyjściu). Nawet najnowocześniejszy model językowy od OpenAI czy Google nie pomoże, jeśli Twoja wewnętrzna baza wiedzy będzie chaotyczna, nieaktualna i pełna sprzecznych informacji. Przygotowanie danych to 70% sukcesu całego projektu.
Zanim programiści przystąpią do konfiguracji bazy wektorowej, musisz przeprowadzić audyt i czyszczenie dokumentacji. Usuń dokumenty nieaktualne (np. regulaminy pracy z 2018 roku, jeśli w 2023 wszedł nowy). Scal rozproszone pliki dotyczące tego samego tematu w jeden spójny dokument. Dbaj o to, by dokumenty miały jasną strukturę nagłówków (H1, H2, H3), co ułatwi parserom poprawne dzielenie tekstu na logiczne fragmenty.
Warto również wprowadzić standard metadanych. Jeśli każdy dokument w bazie będzie posiadał jasne oznaczenia takie jak: data utworzenia, autor, kategoria tematyczna oraz poziom poufności, system RAG będzie mógł działać znacznie precyzyjniej, odrzucając przestarzałe wersje plików podczas wyszukiwania kontekstowego.
Zobaczmy, jak odpowiednie przygotowanie i ustrukturyzowanie danych drastycznie zmienia jakość pracy bota na kolejnym praktycznym przykładzie.
Scenariusz: Firma kurierska chce wdrożyć bota dla kurierów terenowych, który odpowiada na pytania dotyczące procedur doręczania przesyłek niestandardowych.
- Złe podejście (Chaos): Firma wrzuca do bazy wiedzy 50 różnych skanów notatek służbowych, wątków z maili oraz starych instrukcji PDF, w których stawki i procedury wzajemnie się wykluczają. Efekt? Bot na pytanie „Jak postąpić z paczką z płynem?” odpowiada niespójnie, raz każąc spisać protokół szkody, a innym razem odsyłając paczkę do nadawcy na koszt kuriera.
- Dobre podejście (Strukturyzacja): Dział operacyjny tworzy jeden, autorytatywny dokument o nazwie „Procedura Obsługi Przesyłek Niestandardowych v2.0 (2024)”. Każdy przypadek (płyny, szkło, gabaryty) jest opisany w osobnej sekcji z jasnymi krokami: 1, 2, 3. Dokument zostaje oznaczony tagiem
"status": "active". - Efekt: Kurier stojąc u klienta, pyta bota na telefonie: „